ДПО-1 Образовательная программа Для сотрудников любых ролей Синтетические и обезличенные данные

ДПО-1 «Основы применения искусственного интеллекта»

Практический курс для сотрудников, которые хотят понять, как устроены современные нейросети и где они могут быть полезны в повседневных рабочих задачах.

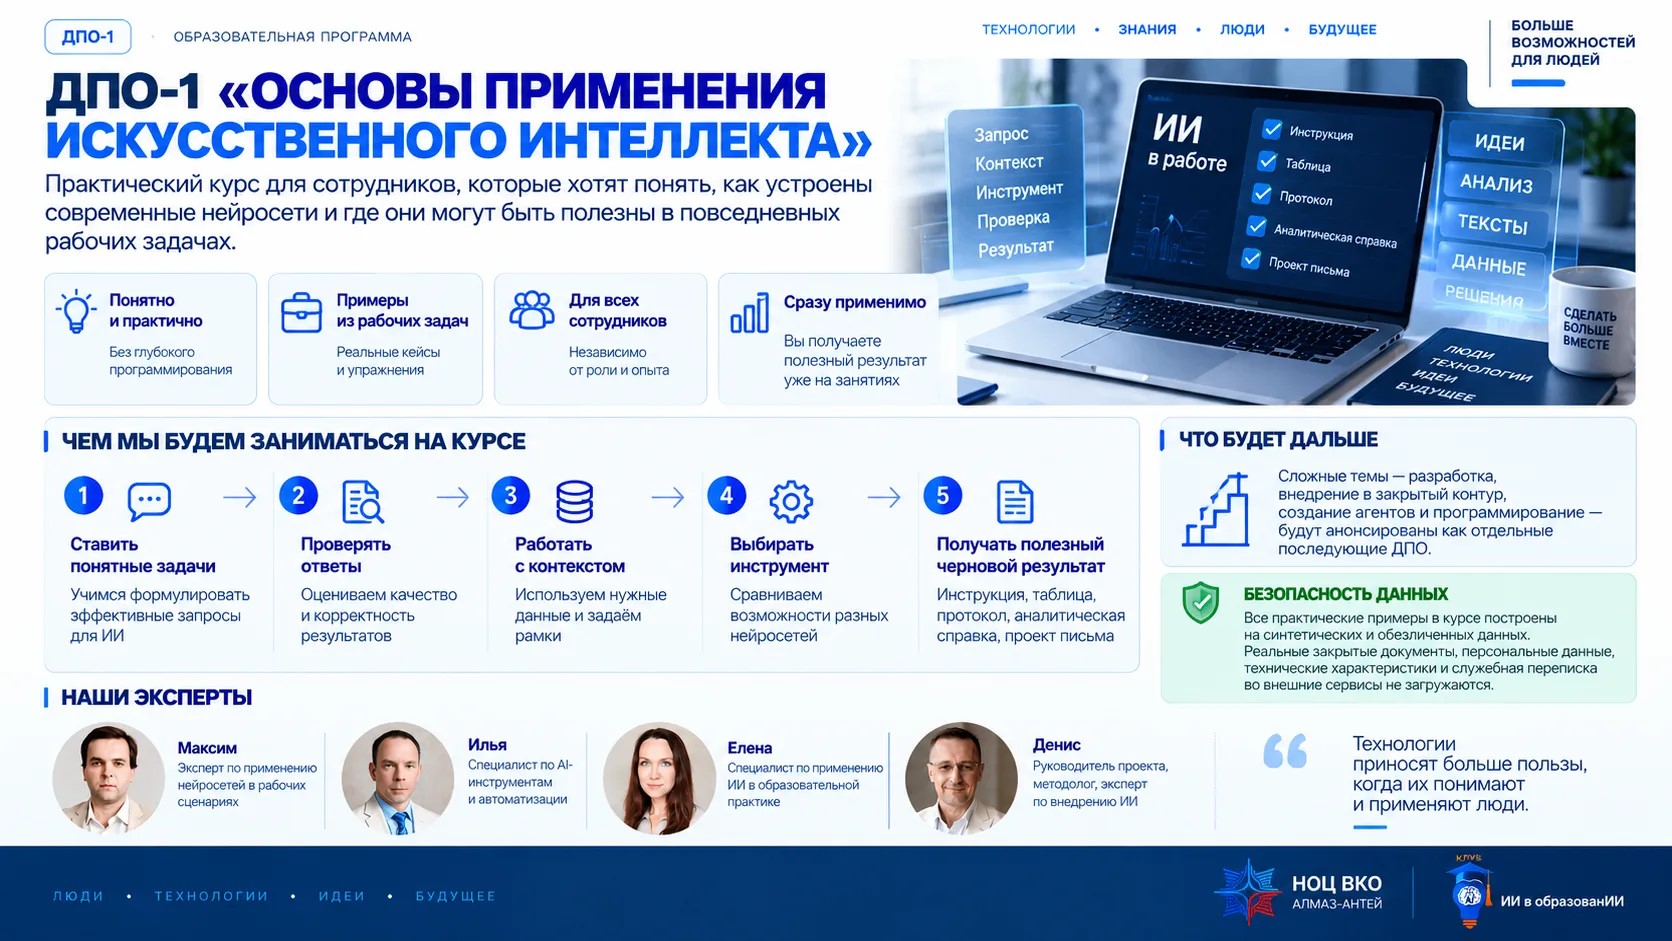
Инфографика курса ДПО-1 «Основы применения искусственного интеллекта»: пять навыков — ставить понятные задачи, проверять ответы, работать с контекстом, выбирать инструмент и получать черновой результат; что будет дальше, безопасность данных и эксперты курса
ДПО-1 «Основы применения искусственного интеллекта» — обзор курса
О курсе

Чему мы учимся на курсе

На занятиях мы будем учиться ставить понятные задачи ИИ, проверять ответы, работать с контекстом, выбирать подходящий инструмент и получать полезный черновой результат: инструкцию, таблицу, протокол, аналитическую справку или проект письма.

1

Ставить понятные задачи

Учимся формулировать эффективные запросы для ИИ.

2

Проверять ответы

Оцениваем качество и корректность результатов.

3

Работать с контекстом

Используем нужные данные и задаём рамки.

4

Выбирать инструмент

Сравниваем возможности разных нейросетей.

5

Получать черновой результат

Инструкция, таблица, протокол, аналитическая справка, проект письма.

🪜 Что будет дальше

Сложные темы — разработка, внедрение в закрытый контур, создание агентов и программирование — будут анонсированы как отдельные последующие ДПО.

🛡️ Безопасность данных
Все практические примеры в курсе построены на синтетических и обезличенных данных. Реальные закрытые документы, персональные данные, технические характеристики и служебная переписка во внешние сервисы не загружаются.

Команда курса

Кто ведёт курс

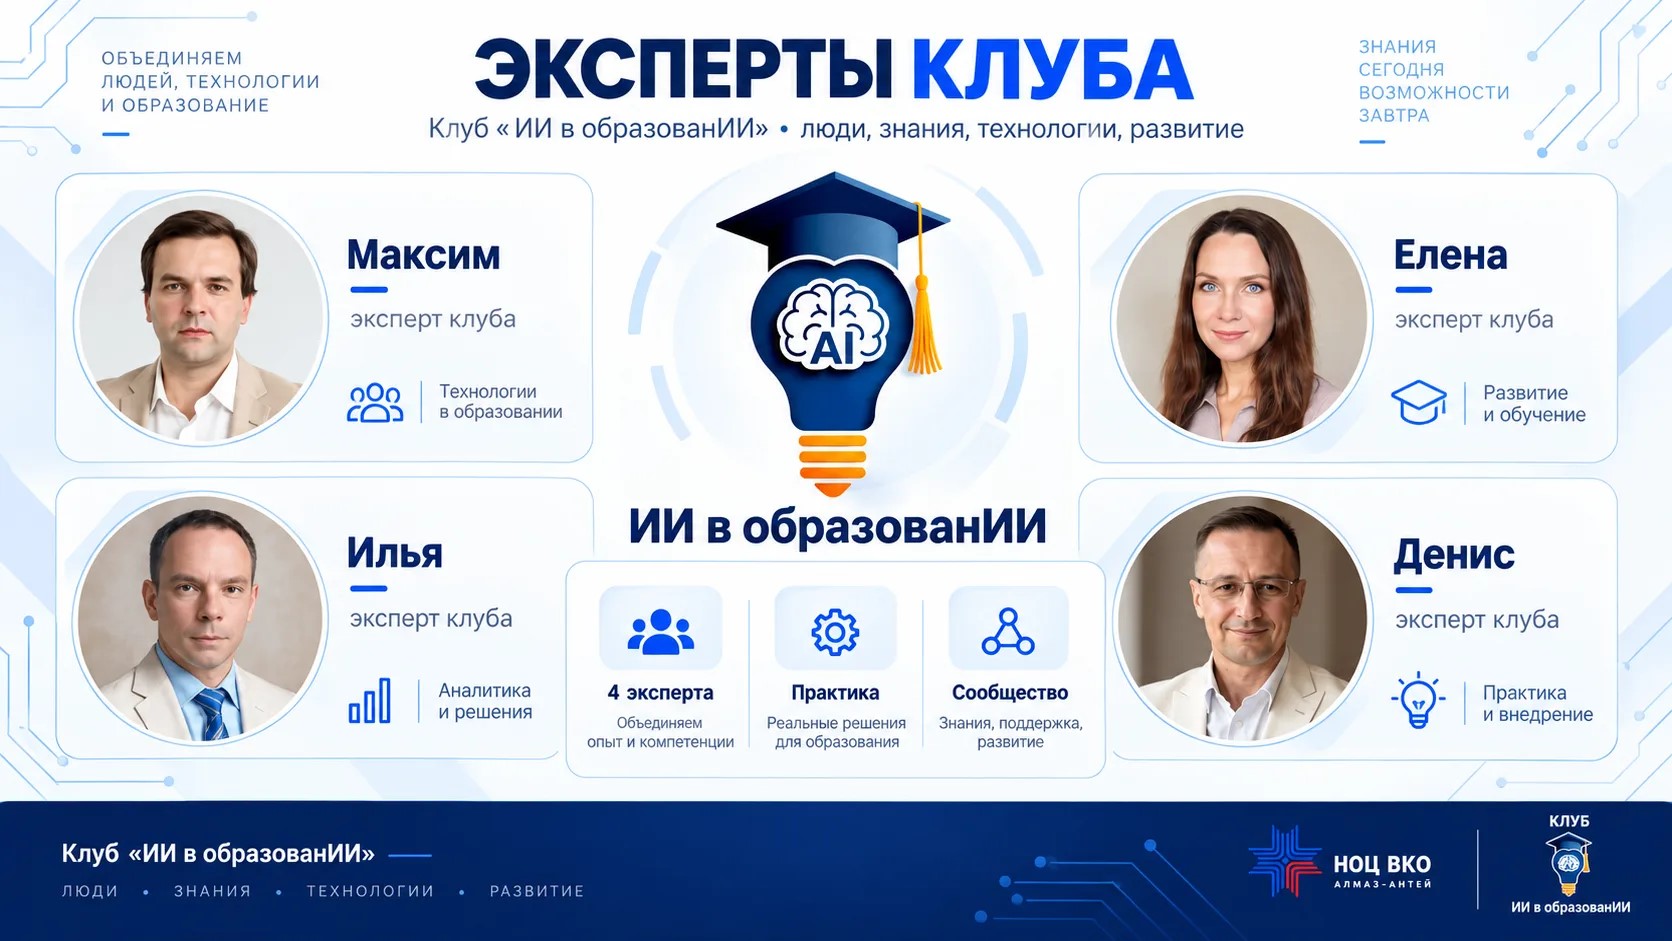
Эксперты Клуба «ИИ в образовании»: методология и внедрение ИИ, преподавание, техническая архитектура и практика применения нейросетей.

Шандалин Денис Анатольевич

Шандалин Денис Анатольевич

Руководитель проекта, методолог, эксперт по внедрению ИИ

Руководитель проекта и Клуба «ИИ в образовании», методолог, эксперт по внедрению искусственного интеллекта в образование и бизнес. Более 20 лет опыта в предпринимательстве, управлении, продажах и работе с коммерческой недвижимостью. Основатель «Агентства Новых Перспектив», разработчик образовательных программ и практических решений на базе ИИ. Специализируется на проектировании AI-ассистентов и агентных систем, внедрении нейросетей в бизнес-процессы, разработке методологии обучения и практических программ дополнительного профессионального образования. Спикер образовательных и отраслевых мероприятий, занимается подготовкой специалистов и внедрением AI-решений в корпоративный сектор.
Курпичев Максим Анатольевич

Курпичев Максим Анатольевич

Кандидат экономических наук, доцент МГУ имени М.В. Ломоносова

Кандидат экономических наук, доцент МГУ имени М.В. Ломоносова, преподаватель курсов по направлению «Инноватика». Более 10 лет опыта преподавания по программам высшего образования, автор и разработчик 10 образовательных курсов. Куратор образовательной онлайн-платформы «ЯСПОСОБЕН», отмеченной на ПМЭФ-2025, куратор проектов «ЯСПОСОБЕН» в рамках Всероссийского акселератора социальных инициатив RAISE. Куратор студенческих стартап-проектов, сертифицированный бизнес-трекер, эксперт Клуба «ИИ в образовании».

Чурилов Илья Владимирович

Чурилов Илья Владимирович

Технический лидер, специалист по AI-инструментам и автоматизации

Сооснователь и эксперт Клуба «ИИ в образовании», технический лидер и специалист по внедрению искусственного интеллекта. Более 15 лет опыта в автоматизации бизнес-процессов, около 3 лет занимается разработкой и внедрением AI-продуктов, чат-ботов, цифровизации HR и образовательных решений. Отвечает за техническую архитектуру, запуск и адаптацию AI-инструментов, автоматизацию рабочих процессов и обучение практическому применению ИИ.

Чепик Елена Юрьевна

Чепик Елена Юрьевна

Эксперт по нейросетям и искусственному интеллекту

Эксперт по нейросетям и искусственному интеллекту, автор образовательных курсов по ИИ, разработчик решений на базе больших языковых моделей. Более 15 лет преподавательского опыта в вузах и других образовательных учреждениях. Проходила обучение в ведущих университетах России и Европы. Специализируется на внедрении ИИ в образовательные программы, обучении практическому применению нейросетей, а также использовании ИИ в журналистике и цифровом искусстве.

Слайд «Эксперты клуба»: Максим, Елена, Илья и Денис — четыре эксперта Клуба «ИИ в образовании»
Эксперты Клуба «ИИ в образовании»
Урок 1

Как устроен современный ИИ

90 минут Начальный уровень Только синтетические примеры

После урока вы сможете отличать запрос от контекста, объяснять роль токенов, замечать перегрузку диалога и выбирать нейросеть под задачу, а не по рейтингу.

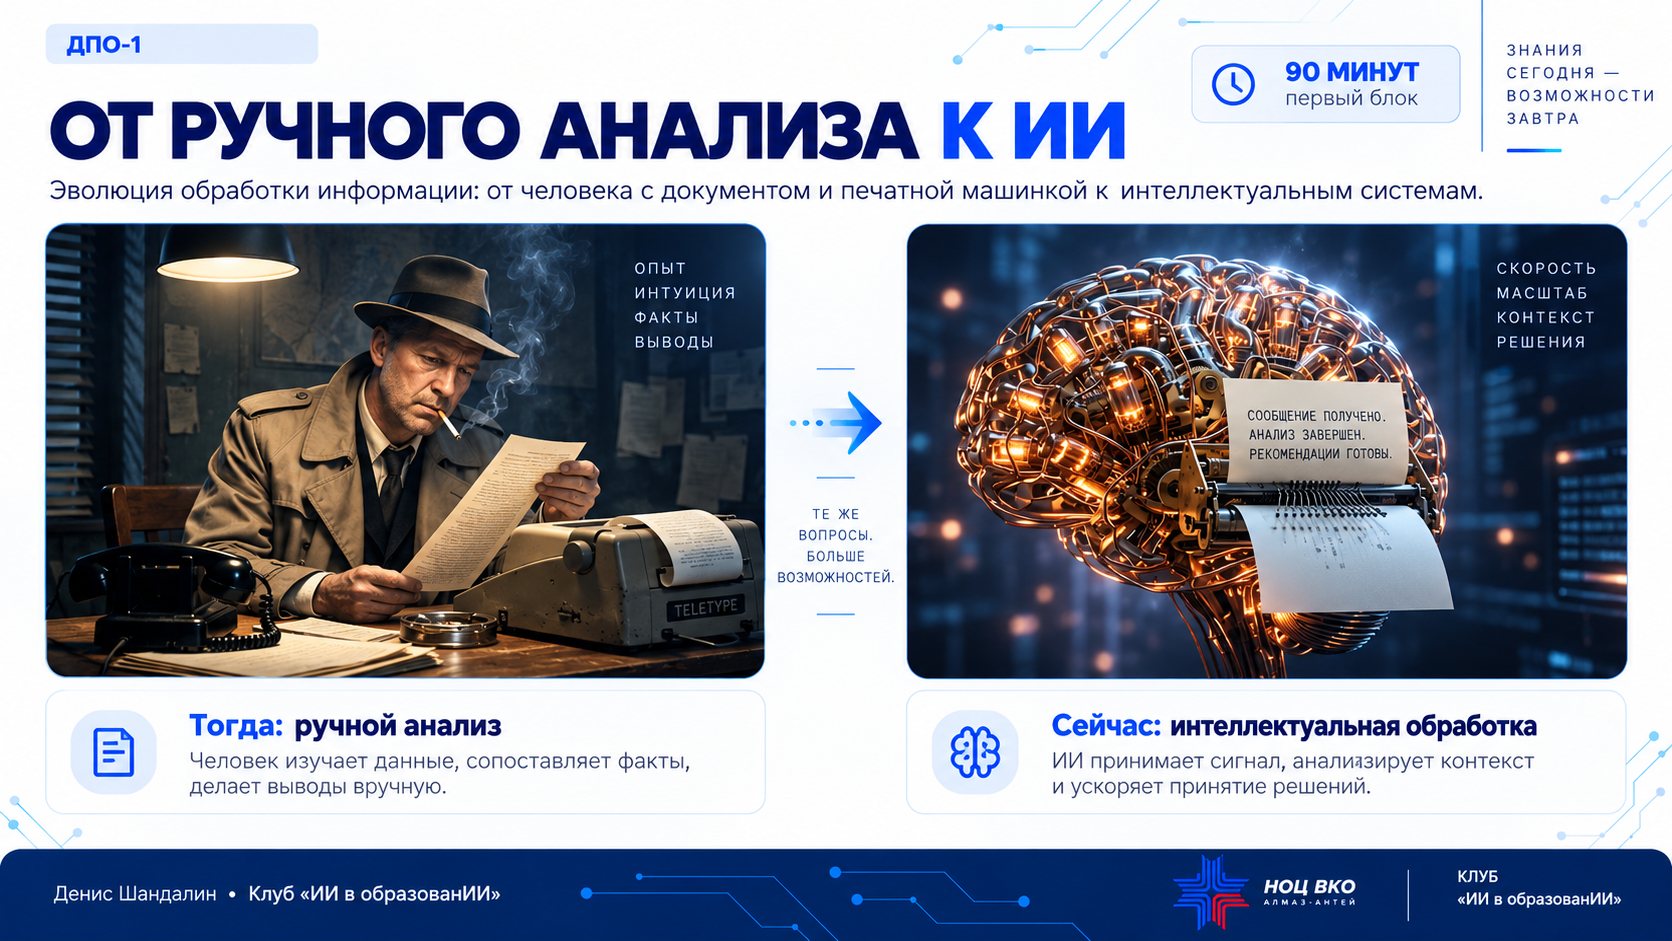
Инфографика «От ручного анализа к ИИ»: слева человек изучает документы вручную, справа нейросеть обрабатывает сигнал и ускоряет принятие решений
«От ручного анализа к ИИ» — обзорный слайд урока
1

История ИИ: от фантастических идей до ChatGPT

Нейросети умеют работать с текстом, но могут ошибаться. Чтобы понять, почему, начнём не с кнопок, а с этапов развития технологии: каждый объясняет одну из её сегодняшних возможностей или ограничений.

🔒 Правило урока: все примеры вымышленные — учебные заявки, короткие отчёты и условия выбора. Реальные документы предприятия во внешние сервисы не передаём.

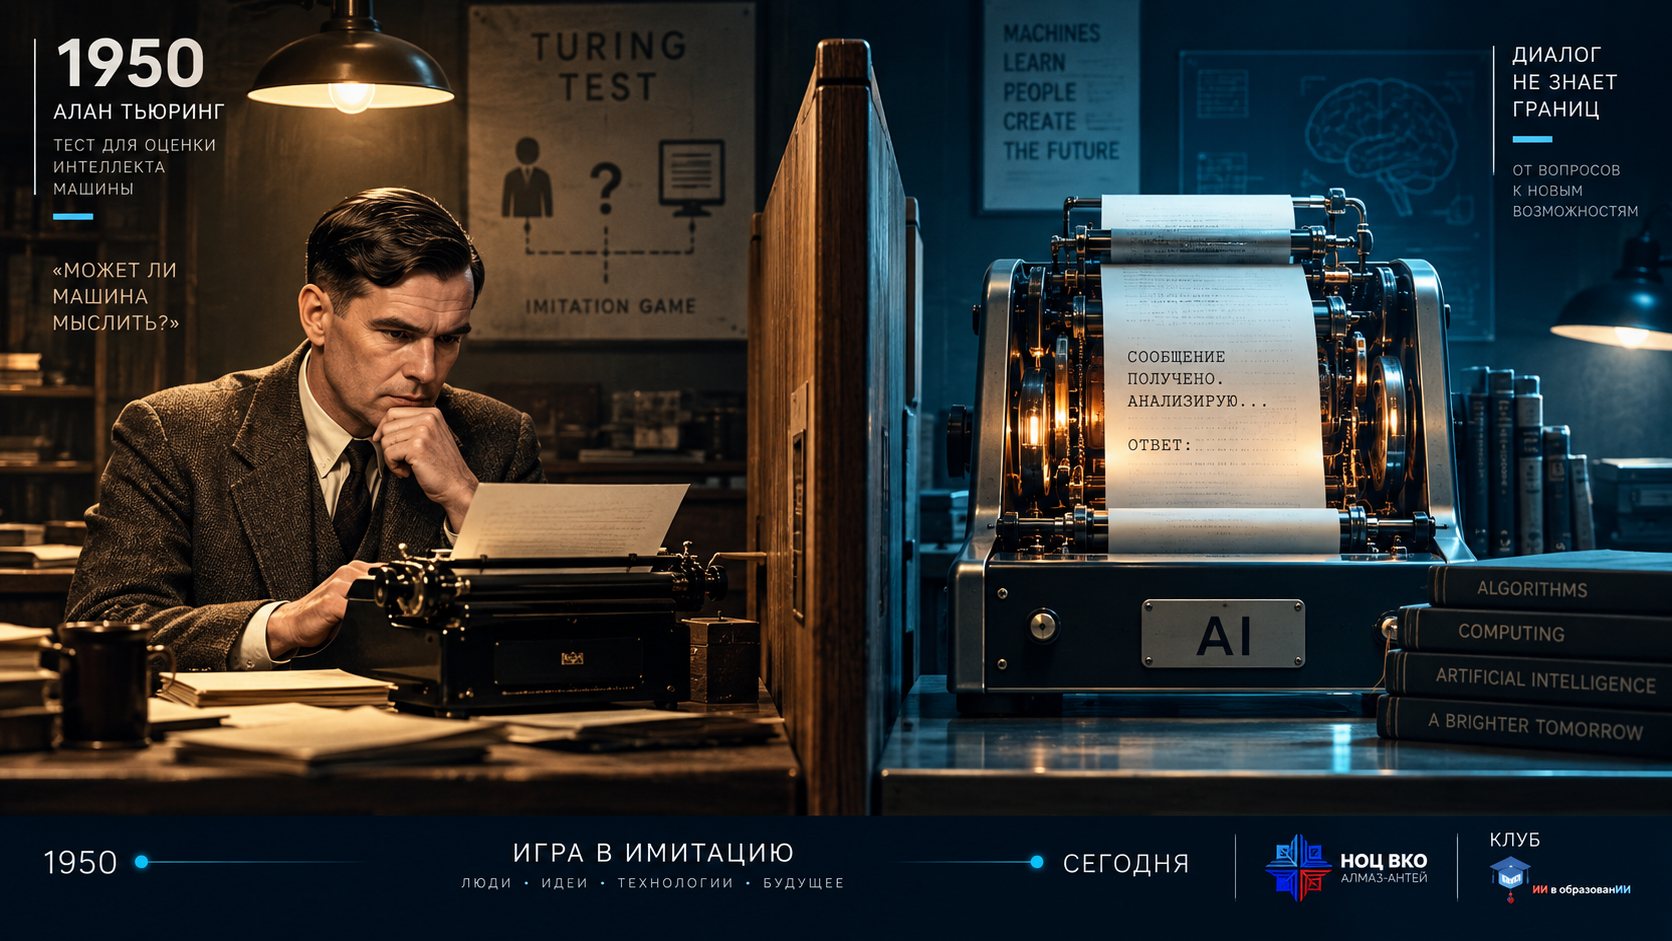
Алан Тьюринг за печатной машинкой рядом с вычислительной машиной: вопрос «Может ли машина мыслить?», 1950 год
1950 — «Игра в имитацию» Алана Тьюринга
Лента истории ИИ: 11 вех — листайте стрелками

Для каждой вехи — суть, объяснение простыми словами и факт, который стоит рассказать коллегам. На проекторе удобно включить «Автопоказ».

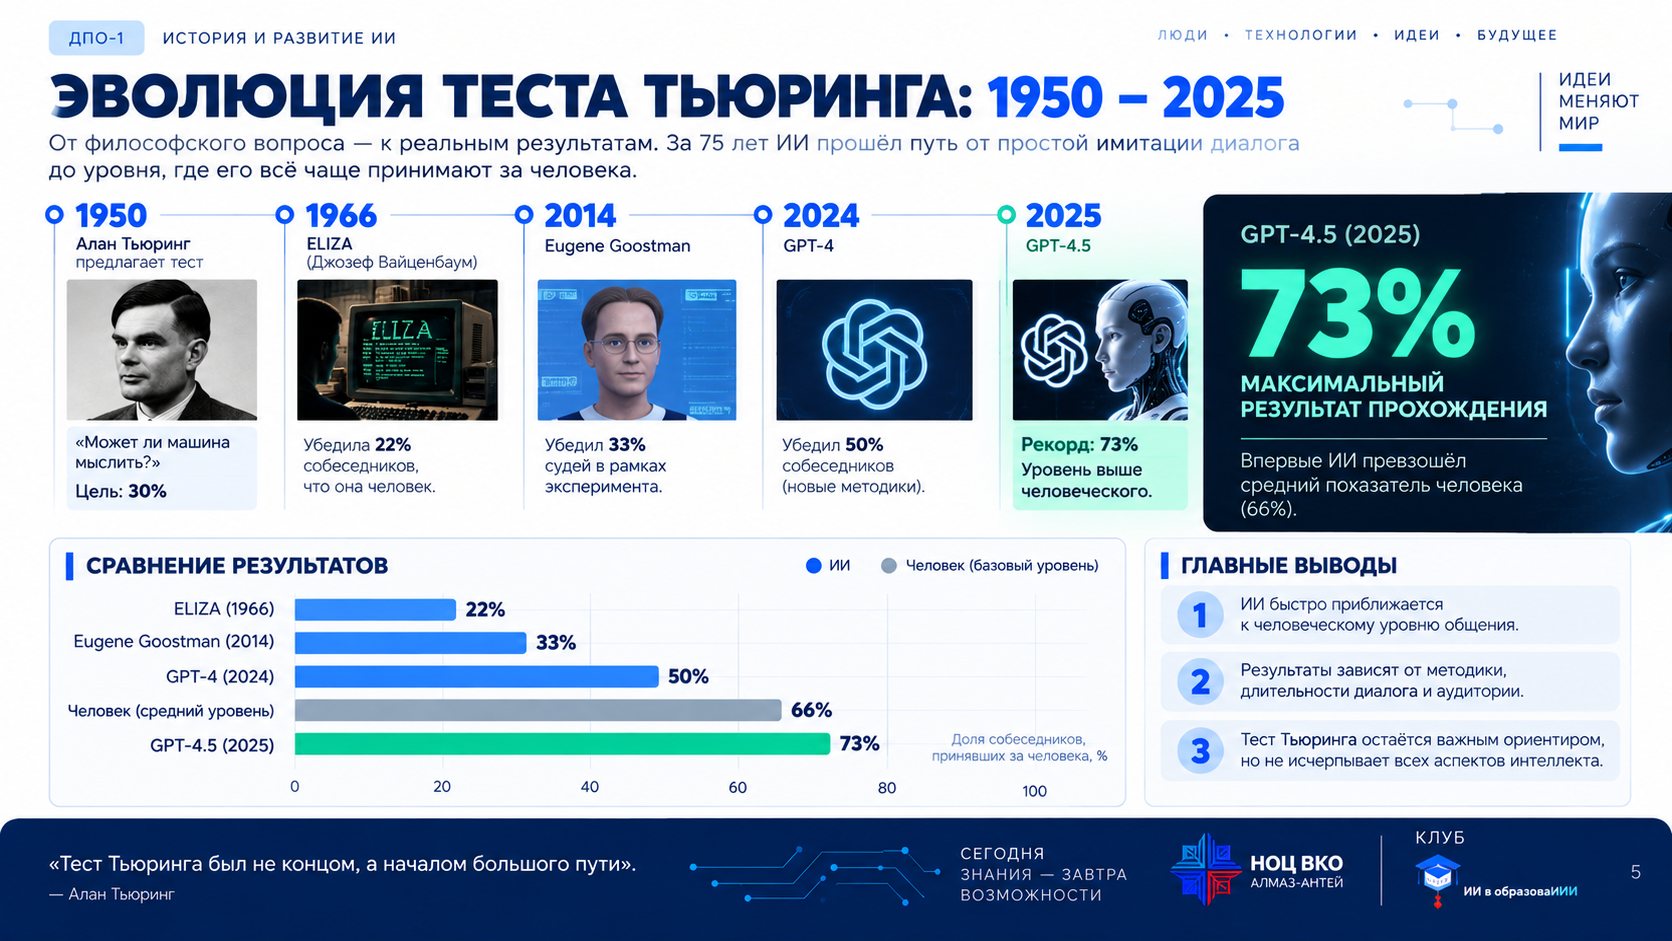
Что изменилось за 75 лет

Эволюция теста Тьюринга 1950–2025: ELIZA убеждала 22% собеседников, Eugene Goostman — 33%, GPT-4 — 50%, GPT-4.5 — 73% при среднем показателе человека 66%
Эволюция теста Тьюринга: 1950 → 2025
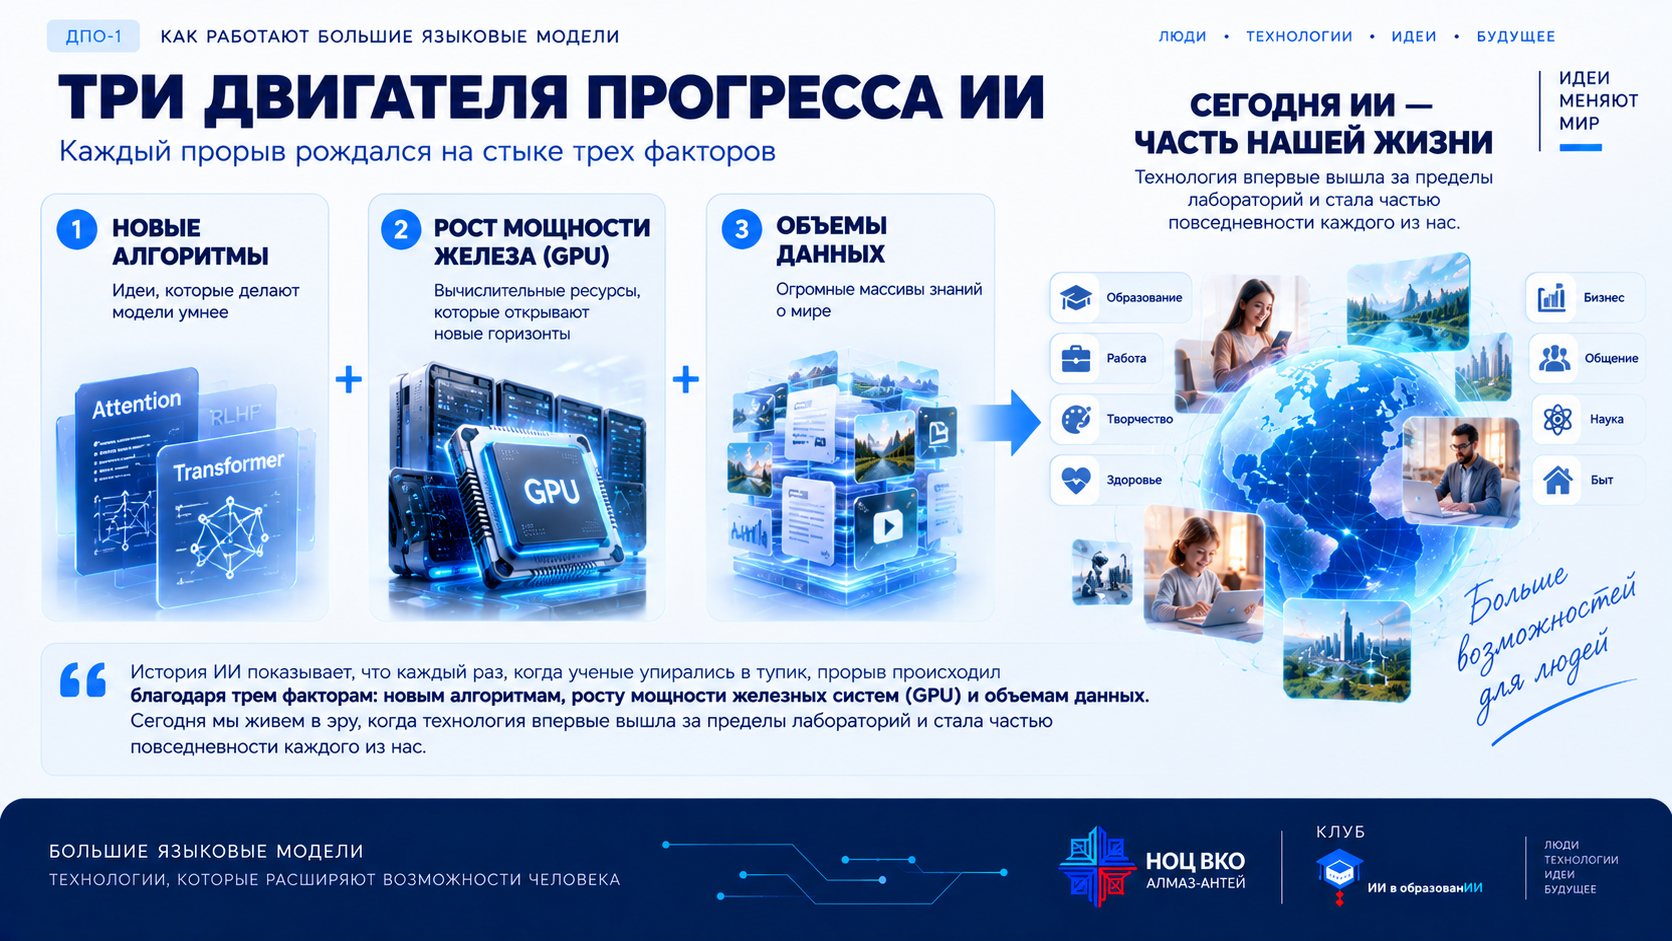
Три двигателя прогресса ИИ: новые алгоритмы, рост мощности железа (GPU) и объёмы данных
Три двигателя прогресса ИИ

Как читать цифры теста ТьюрингаПроценты на слайде получены в разных экспериментах с разной методикой и длительностью диалога. Их нельзя складывать в одну «линейку прогресса». Пройденный тест показывает умение имитировать разговор, а не наличие понимания или сознания.

История ИИ показывает: каждый раз, когда учёные упирались в тупик, прорыв происходил благодаря трём факторам — новым алгоритмам, росту мощности «железа» (GPU) и объёмам данных. Сегодня технология впервые вышла за пределы лабораторий и стала частью повседневности каждого из нас.
2

Как устроен трансформер: что прячется в буквах GPT

В 2017 году исследователи Google в статье «Attention Is All You Need» представили архитектуру Transformer. На ней построены ChatGPT, GigaChat, YandexGPT, DeepSeek и другие большие языковые модели (LLM — Large Language Model). Разберём её за три шага.

G

Generative — генеративная

Не выдаёт заготовленный шаблон. На каждый вопрос заново вычисляет, какое слово логичнее поставить следующим, и «сочиняет» ответ на ваших глазах.

P

Pre-trained — предварительно обученная

Как человек, прочитавший огромную библиотеку. Модель не заучивает факты наизусть, а усваивает закономерности языка.

T

Transformer — трансформер

Архитектура с механизмом внимания: удерживает нить разговора и понимает, как слова связаны между собой во всём тексте.

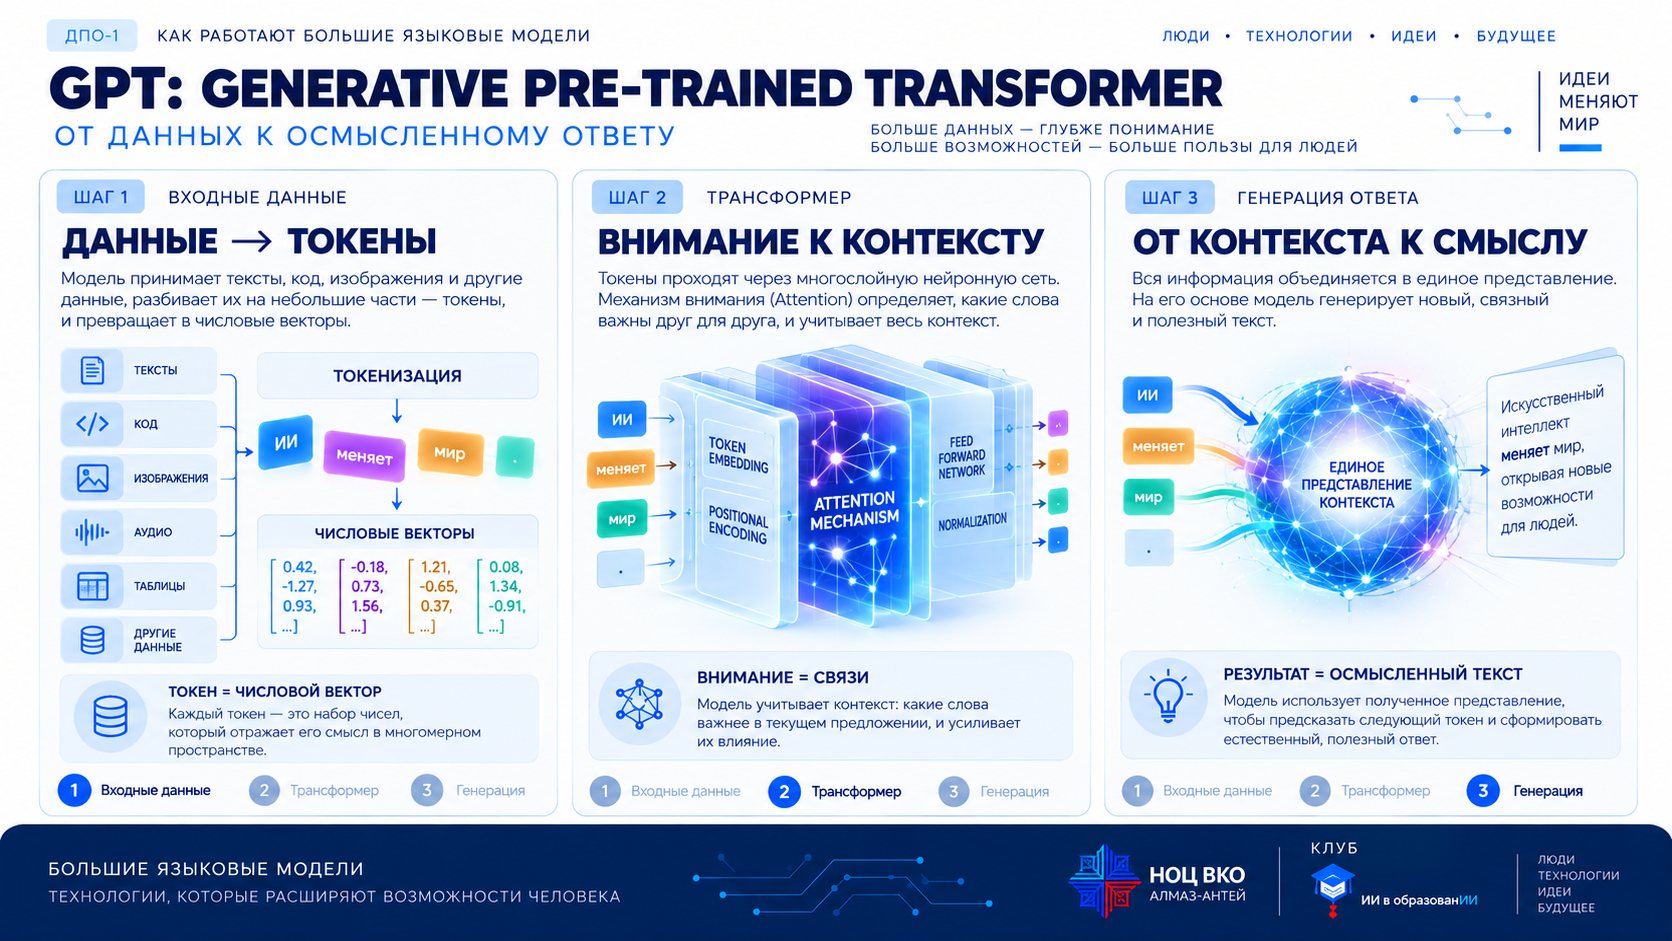
Схема Generative Pre-trained Transformer в три шага: данные превращаются в токены, трансформер вычисляет внимание к контексту, из контекста генерируется осмысленный ответ
GPT: от данных к осмысленному ответу
Разбить на токены и векторы→Найти связи через внимание→Сгенерировать ответ

Шаг 1. Токенизация и эмбеддинги

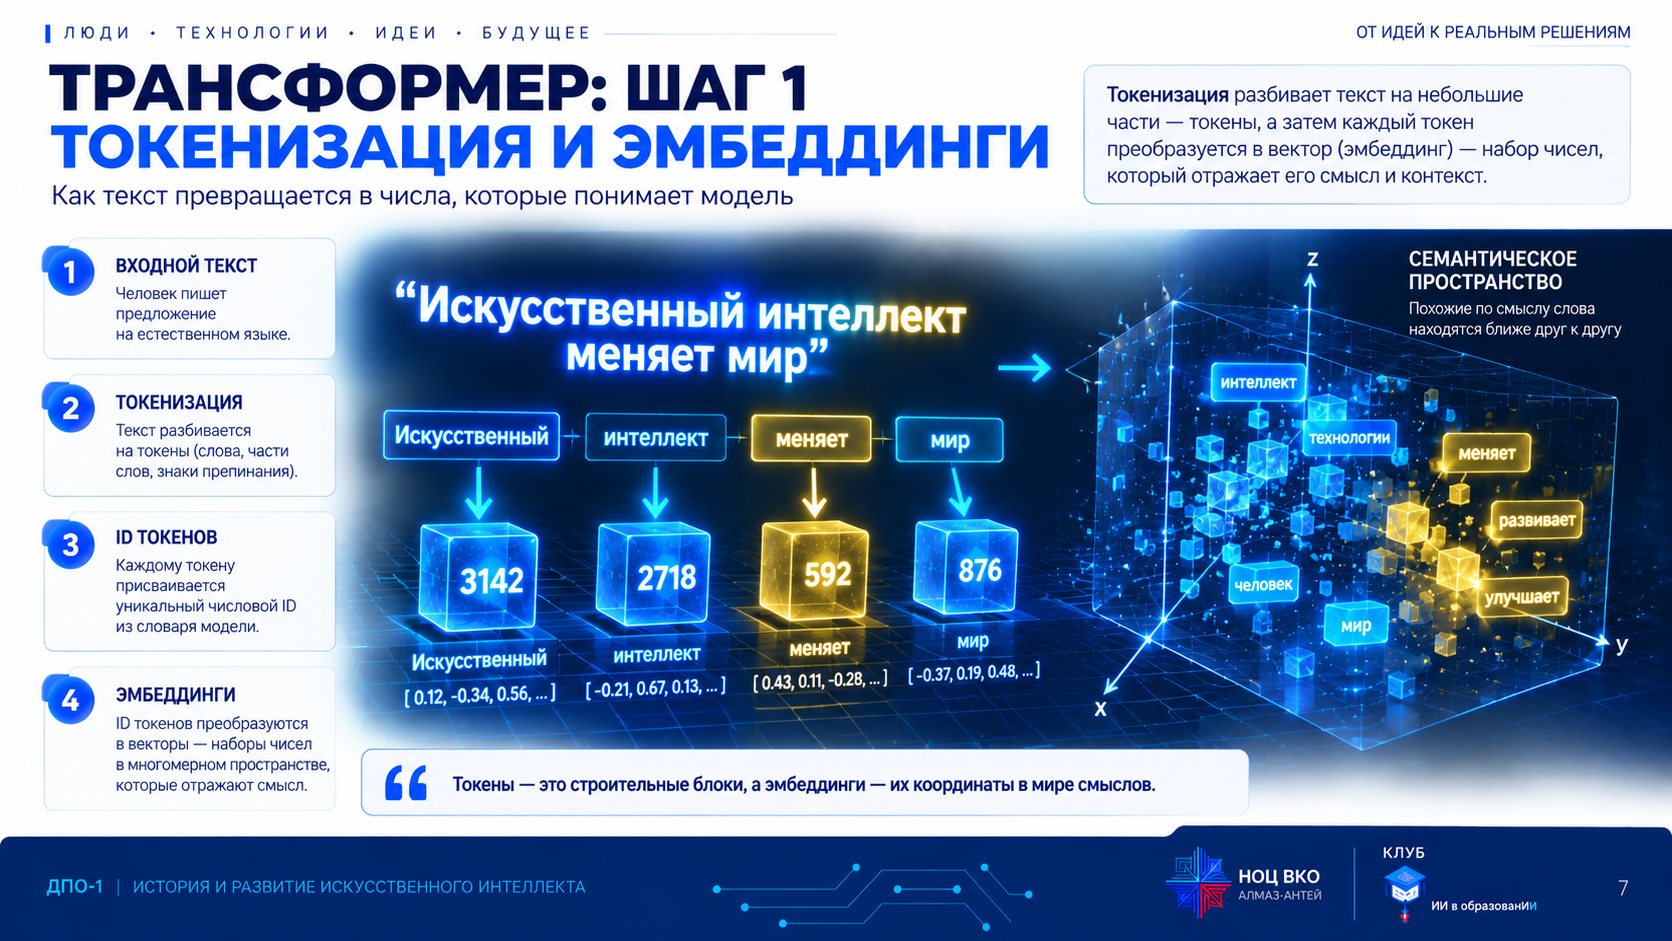
Компьютер не читает слова так, как мы: для него текст — набор символов. Поэтому модель сначала режет предложение на кусочки — токены (целые слова или их части). Затем каждый токен превращается в эмбеддинг — вектор, набор чисел-координат в многомерном пространстве.

Метафора: карта смысловБлизкие по смыслу слова — «кошка» и «собака» — лежат на карте рядом, а «экскаватор» — далеко от них. Текст превращается в набор точек, с которыми уже можно считать.

Шаг 1 трансформера: фраза «Искусственный интеллект меняет мир» разбита на токены с числовыми ID и превращена в векторы в семантическом пространстве
Шаг 1: токенизация и эмбеддинги

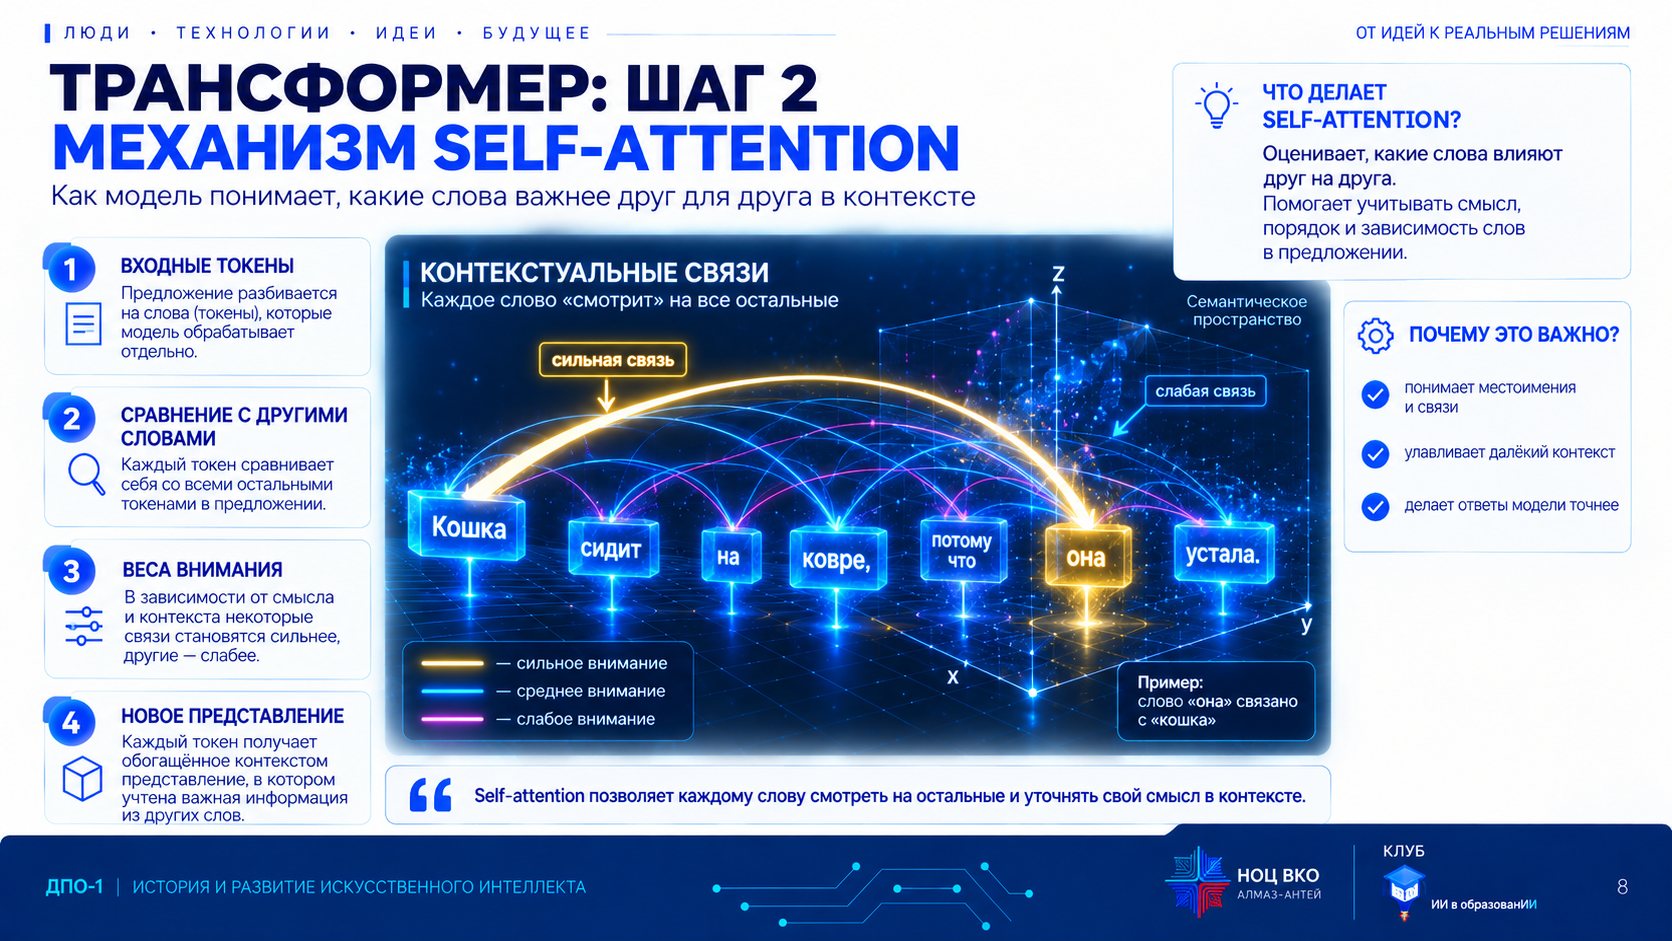
Шаг 2. Механизм внимания (Self-Attention)

Раньше нейросети читали текст по порядку и к концу длинного предложения «забывали» начало. Трансформер смотрит на всё предложение целиком и сразу: прокладывает связи между всеми словами и оценивает, насколько они важны друг для друга.

Во фразе «Заяц убежал от волка, потому что он был быстрым» внимание натягивает сильную «нить» между «он» и «заяц». Модель улавливает, кто был быстрым и кто от кого убегал.

Шаг 2 трансформера: механизм Self-Attention связывает слово «она» со словом «кошка» во фразе «Кошка сидит на ковре, потому что она устала»
Шаг 2: механизм Self-Attention
Механизм внимания: нажмите на любое слово

Сравните первые два предложения: одно слово «не» меняет смысл — и внимание переключается с зайца на волка.

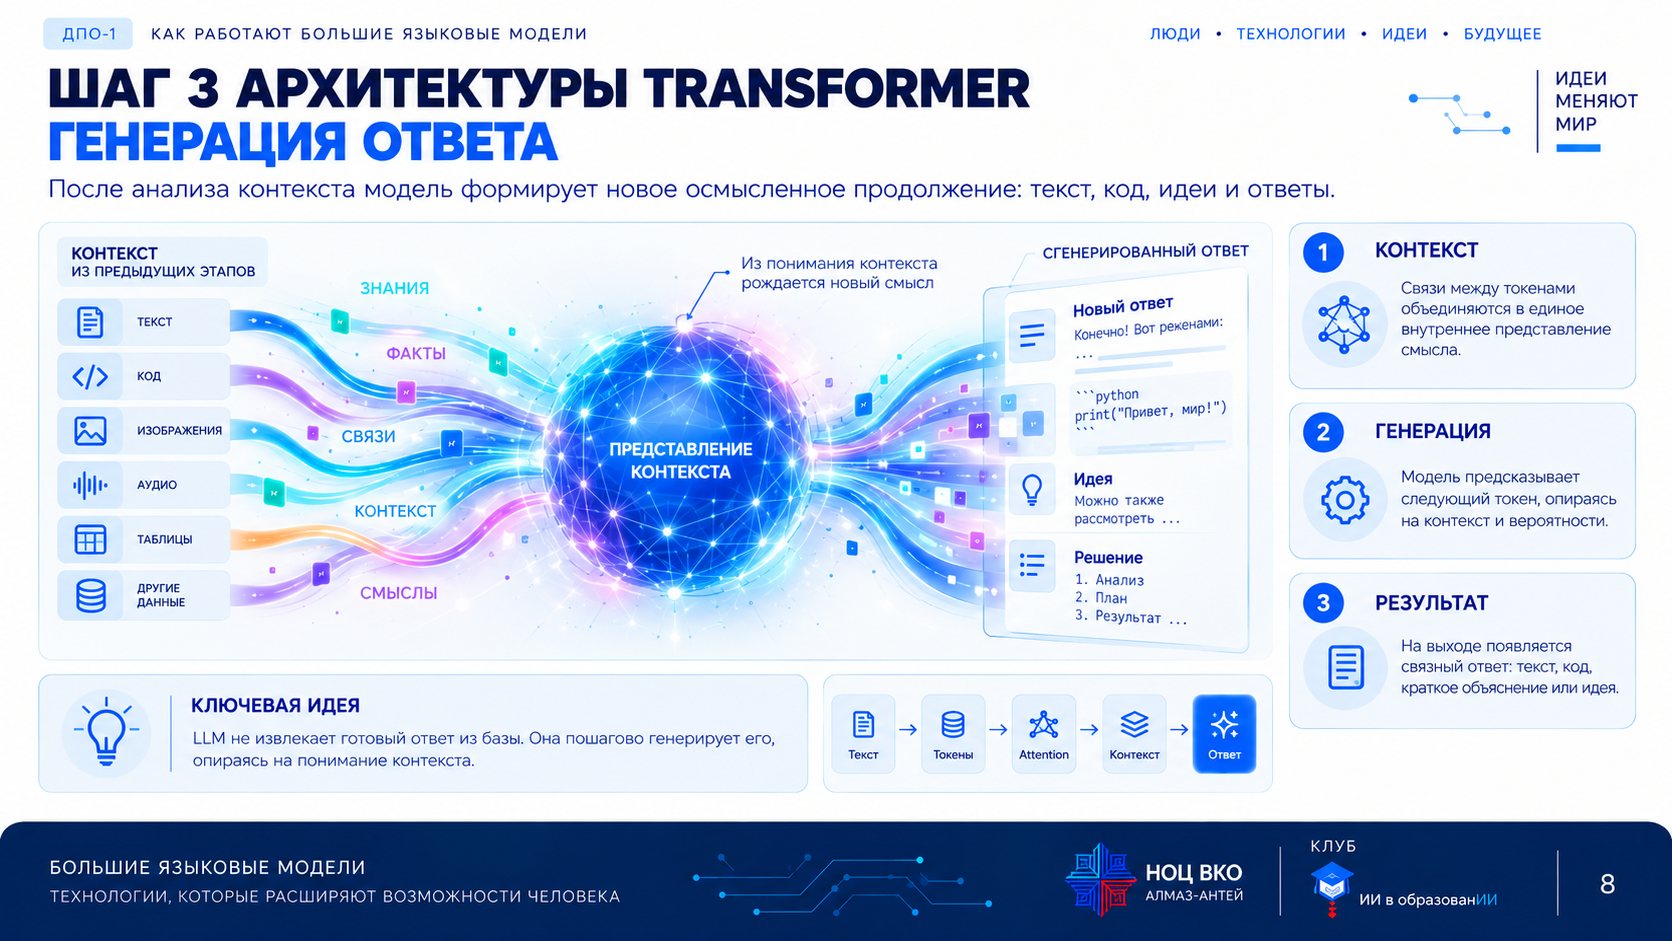
Шаг 3. Генерация ответа из контекста

Пройдя через десятки слоёв внимания, отдельные слова и связи складываются в общее представление контекста. На его основе модель вычисляет вероятность следующего слова и строит связный ответ — продолжение статьи, перевод или код.

LLM не извлекает готовый ответ из базы. Она пошагово генерирует его, опираясь на понимание контекста.

Шаг 3 трансформера: контекст из текста, кода и изображений объединяется в представление, из которого генерируется новый ответ
Шаг 3: генерация ответа
3

LLM — генератор вероятностей, а не поисковик

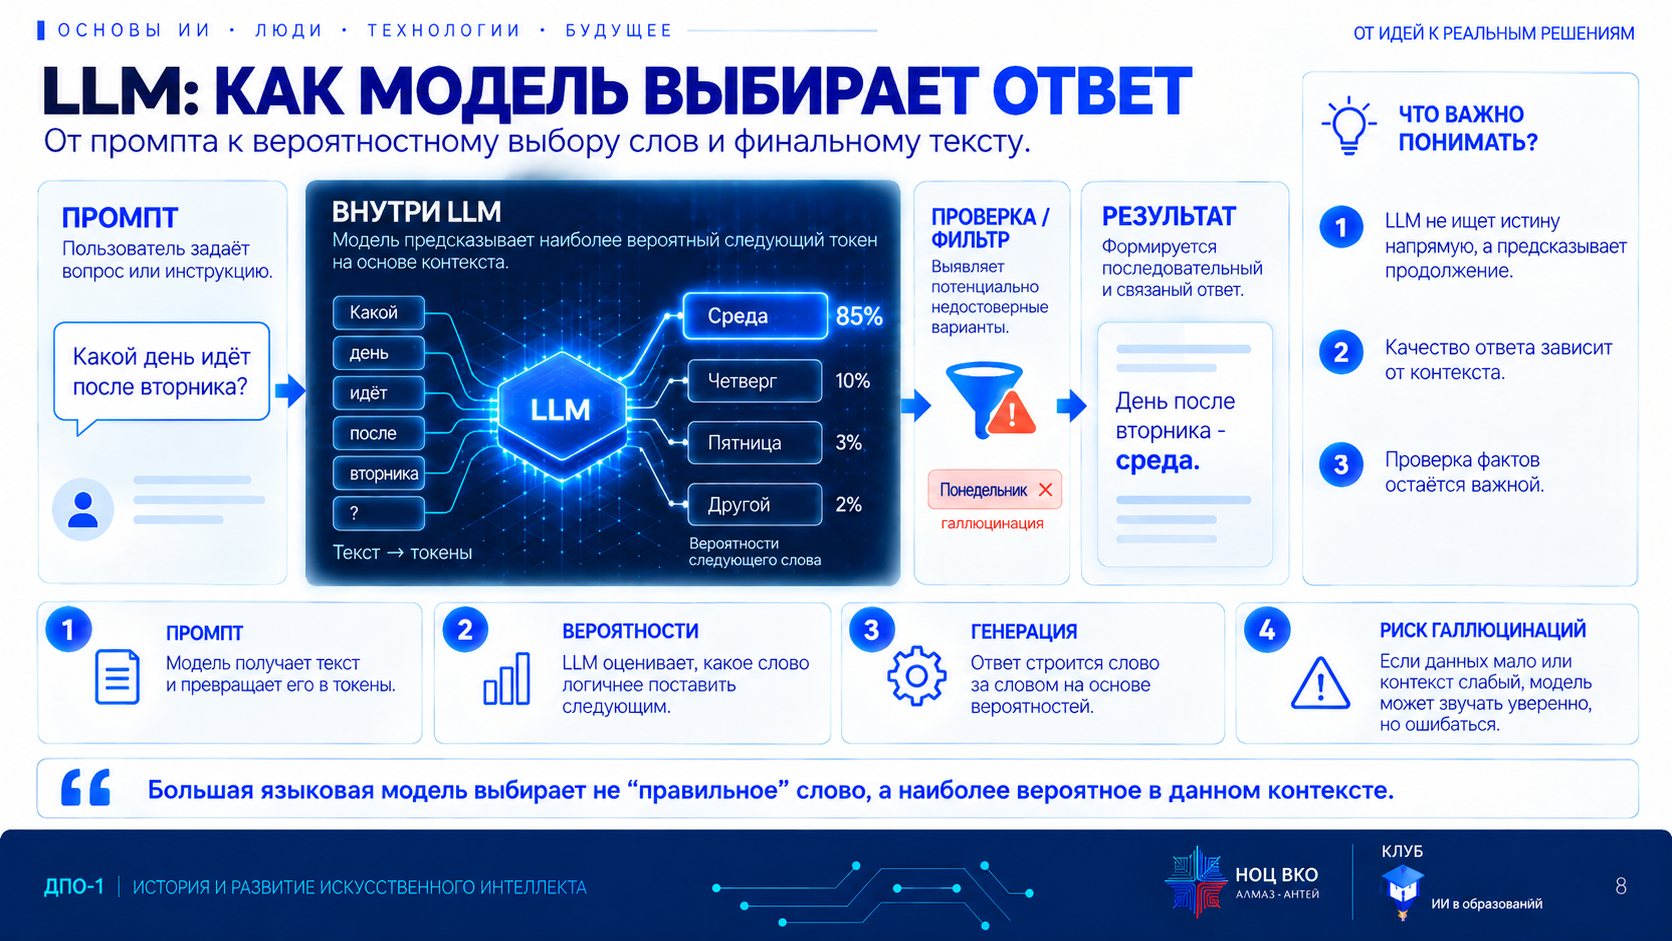
Главная ловушка: модель не ищет готовый документ. Она досочиняет ответ на лету, угадывая каждое следующее слово. Если данных не хватает, она не признаётся, а уверенно додумывает.

Метафора: Т9 на максималкахКогда вы пишете в смартфоне «Я иду в…», Т9 предлагает «магазин» или «офис». LLM делает то же самое, но прочитала огромную часть интернета и строит длинные смысловые цепочки, а не одно слово.

Это ваш идеальный, но фантазирующий стажёр: пишет гладко и уверенно, даже когда не знает ответа.

Вход 📥

Ваши инструкции и исходные факты — контекст.

Процесс ⚙️

Токенизация (текст → числа) → расчёт вероятностей → генерация по шагам.

Главный риск ⚠️

Галлюцинации: модель стремится заполнить пустоту любой ценой.

Правило работы 📏

Модель не проверяет факты в реальном времени, если к ней явно не подключён поиск.

Как LLM выбирает ответ: на вопрос «Какой день идёт после вторника?» модель оценивает варианты — среда 85%, четверг 10%, пятница 3% — и выбирает самый вероятный
LLM: как модель выбирает ответ
Как LLM досочиняет ответ — две вкладки
Разбор примера: биография несуществующего изобретателя

1. Вход. Запрос с выдуманным фактом: «Напиши биографию профессора Алексея Веселовского, который изобрёл квантовый опреснитель воды в Тюмени в 2018 году».

2. Процесс. Текст превращается в токены. Модель знает, как устроены биографии: после имени идут годы жизни, вуз, награды, описание изобретения. Каждое следующее слово она выбирает по принципу «что звучит правдоподобнее всего дальше» — город, лаборатория, научные термины.

3. Результат. Три гладких абзаца в научном стиле, с датами и названиями институтов. В реальности изобретателя квантового опреснителя в Тюмени не существует.

4. Почему так. Модель не заглянула в энциклопедию и реестр патентов. Она увидела команду «Напиши биографию» и контекст «квантовый опреснитель» — и построила статистически идеальный текст, который выглядит как настоящий.

⚠️ ИИ даёт не правду, а наиболее вероятное продолжение вашего текста. Спросите о том, чего нет, — и вместо «я не знаю» получите то, что звучит максимально правдоподобно.

Где границаПодключённый поиск или загруженные документы снижают риск выдумки, но не отменяют проверку: модель может неверно пересказать и настоящий источник. Факты, цифры, ссылки и нормативы в ответе проверяет человек.

4

Экосистема ИИ: формат задачи определяет класс инструмента

Не пытайтесь заставить текстовый чат идеально нарисовать схему или распознать звук без нужных модулей. Сначала посмотрите на исходные данные и операцию — потом выбирайте инструмент.

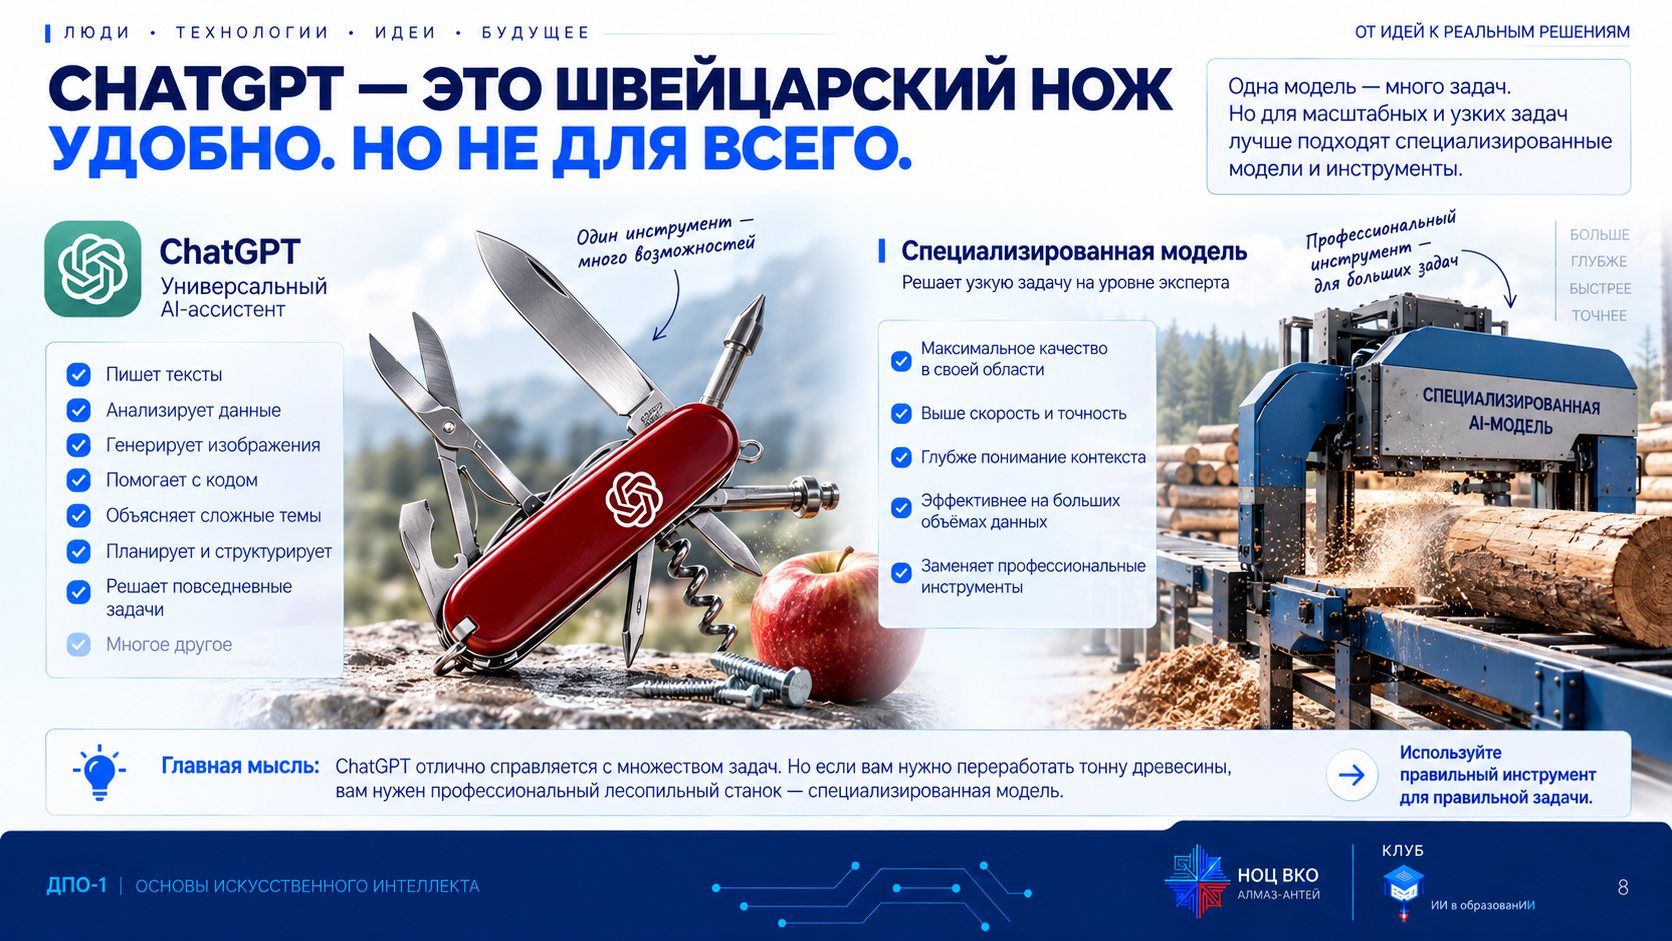
Метафора: швейцарский нож и лесопильный станокChatGPT и другие универсальные чаты — швейцарский нож: и яблоко порезать, и шуруп закрутить. Удобно! Но чтобы переработать тонну древесины, нужен лесопильный станок — специализированная модель.

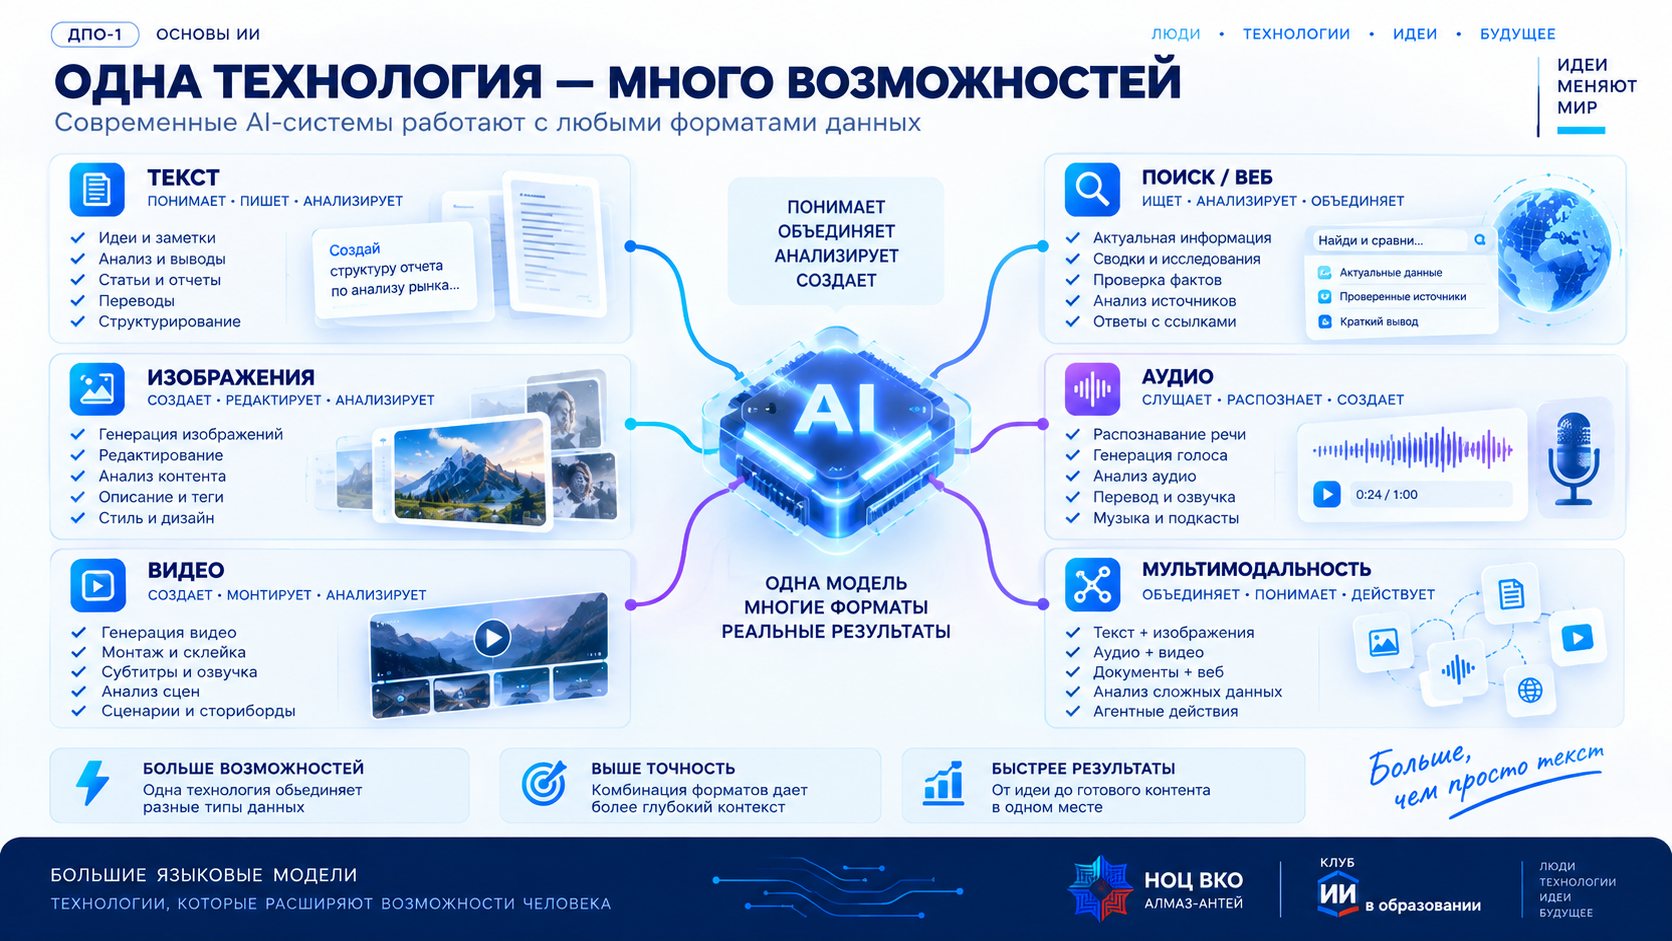
Одна технология — много возможностей: текст, изображения, видео, поиск, аудио и мультимодальность в современных ИИ-системах
Одна технология — много форматов
ChatGPT как швейцарский нож против специализированной ИИ-модели как лесопильного станка: универсальность против экспертного качества в узкой задаче
ChatGPT — швейцарский нож. Удобно, но не для всего
Матрица задач: от формата данных к классу инструмента
Входной форматЗадачаКласс инструмента
ТекстРезюме, письмо, кодLLM — текстовые модели
ПоискСвежие факты, ссылкиRAG / Web-Search AI — поиск по источникам; бывает встроенной функцией LLM
ИзображениеСхема, дизайн, визуализацияДиффузионные модели (генерация) / Vision AI (распознавание)
АудиоПротокол встречи, подкастSpeech-to-Text (распознавание речи) / TTS (синтез речи)
Мультимодальный ввод«Посмотри на график и объясни»Мультимодальная LLM

RAG (Retrieval-Augmented Generation) — «генерация с подсказкой из источников»: сначала система находит нужные документы, потом модель отвечает по ним. Как экзамен с открытой книгой.

Где границаМультимодальная система умеет принимать и создавать разные типы данных, но это не значит, что все функции одинаково качественные. Текстовую записку можно сократить языковой моделью; для поиска первоисточника нужен доступ к источникам; аудиозапись сначала распознают. И главное: кнопка «загрузить файл» в интерфейсе не даёт разрешения загружать производственные материалы.

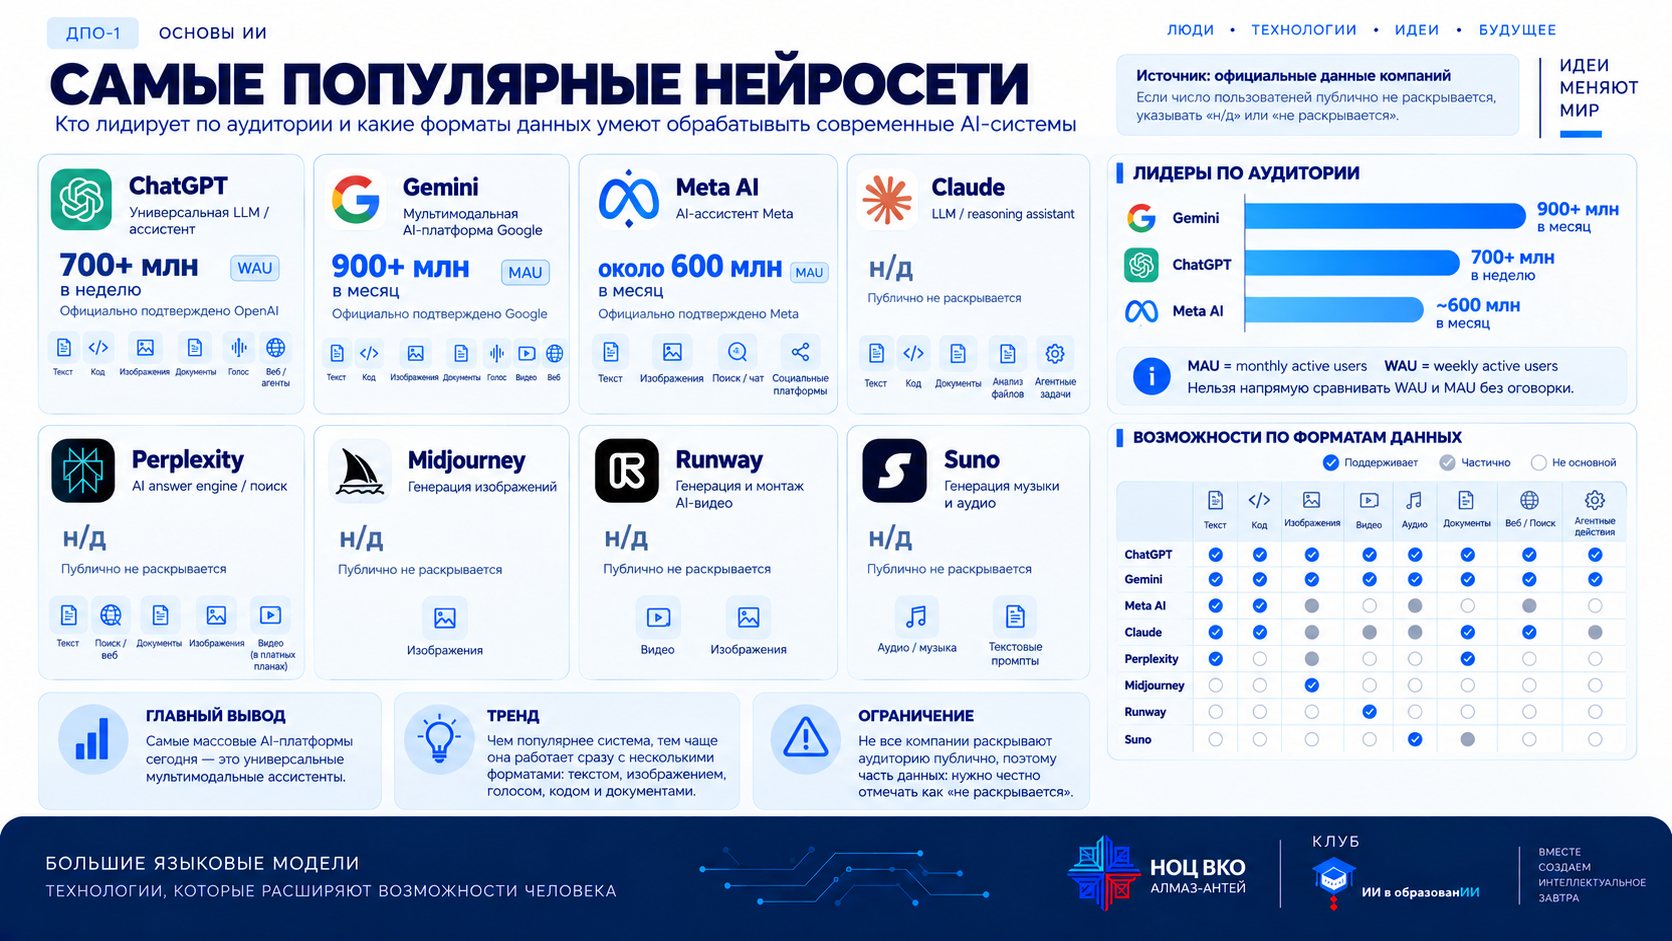
Самые популярные нейросети по данным компаний: ChatGPT, Gemini, Meta AI, Claude, Perplexity, Midjourney, Runway, Suno — аудитория и поддерживаемые форматы данных
Самые популярные нейросети и их форматы

Аудитория на слайде — данные самих компаний: одни раскрывают недельную аудиторию (WAU), другие месячную (MAU), поэтому сравнивать цифры напрямую нельзя. Большинство сервисов со слайда официально недоступны из РФ — актуальный статус смотрите в блоке 7. Компания Meta признана экстремистской организацией и запрещена в России.

5

Промпт и токены: как управлять результатом

Промпт (prompt — «подсказка, инструкция») — запрос, который вы отправляете нейросети. Он задаёт роль ИИ, стиль, формат и точность ответа. Токен — единица текста, которой модель «читает» и «пишет».

Метафора: телеграмма с оплатой за знакиВ XIX веке за телеграмму платили за каждый знак. ИИ тоже «читает» не страницами Word, а токенами — фрагментами слов, — и у каждого диалога есть бюджет.

Увеличить шрифт в документе — не значит потратить больше токенов. А вот лишнее вежливое вступление отнимает полезное место.

Что такое токен

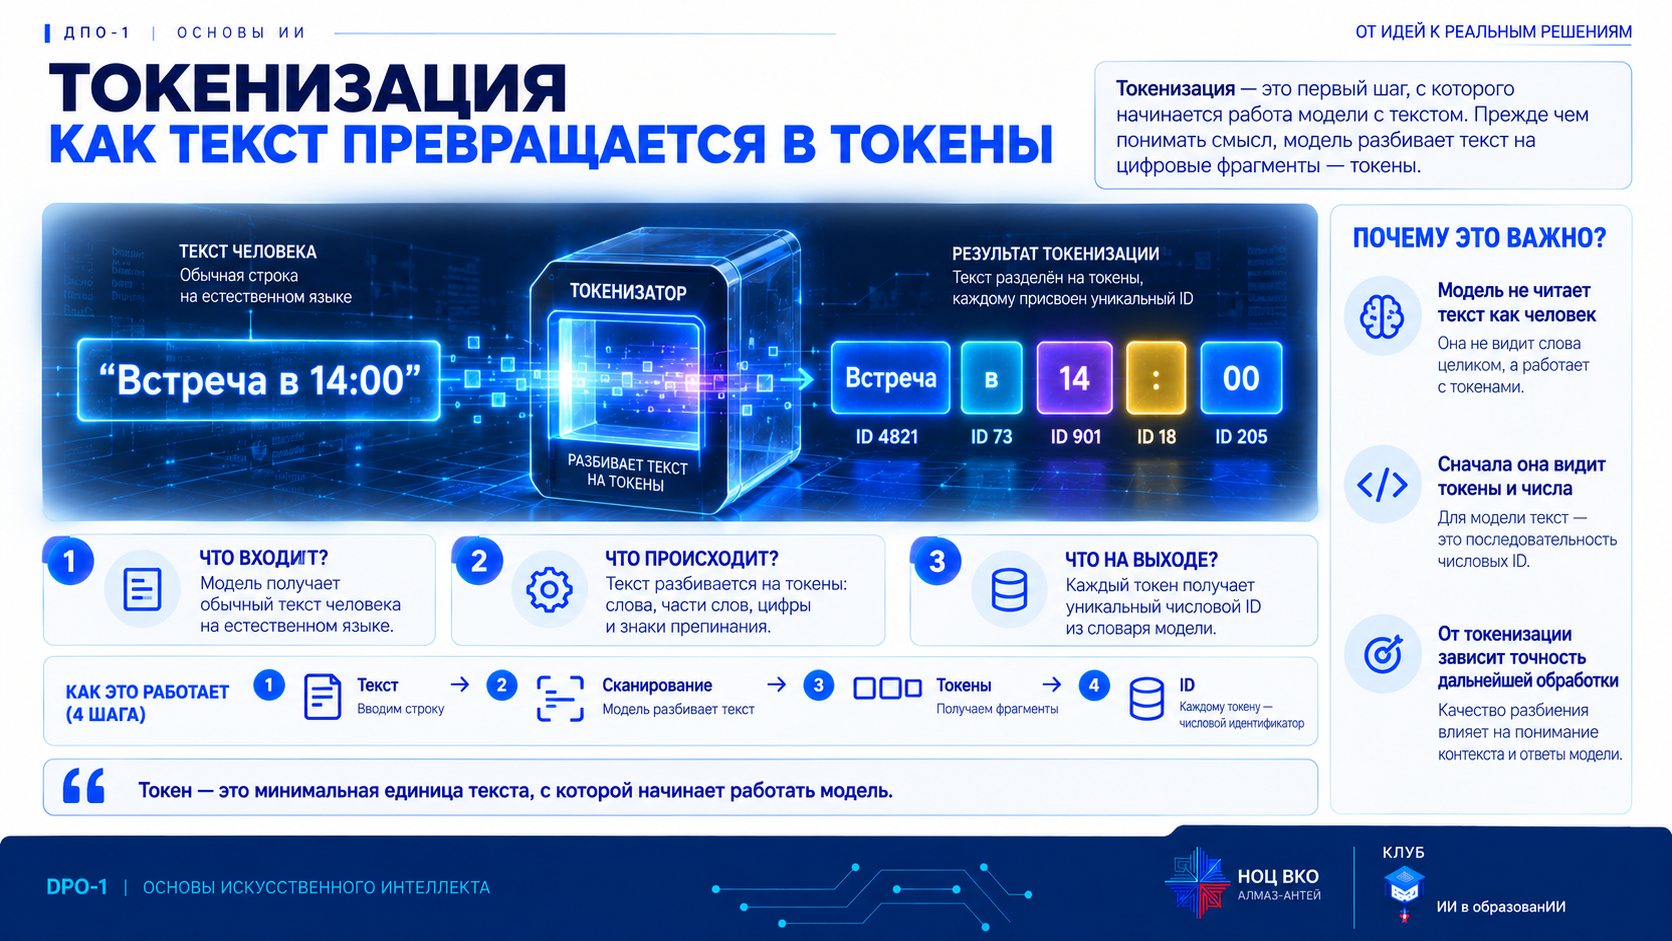
Токеном бывает целое слово, его часть, отдельный символ или знак препинания. Модель переводит каждый токен в числовой код.

  • Простые частые слова («дом», «apple», «ок») — обычно 1 токен.
  • Редкие и длинные слова дробятся: «непредусмотрительность» — 3–6 токенов.
  • Пробелы, знаки, цифры и эмодзи — отдельные токены или их части.
  • English: 1 токен ≈ 4 символа (≈ 0,75 слова), 100 токенов ≈ 75 слов.
  • Русский: обычное слово чаще всего 2–4 токена — лимиты расходуются быстрее.

Почему кириллица «дороже»Большинство моделей обучали в основном на английских текстах, и их словари токенов лучше приспособлены к английскому. Насколько дороже русский, зависит от токенизатора: у новых моделей разрыв заметно меньше.

Токенизация: строка «Встреча в 14:00» разбита токенизатором на токены «Встреча», «в», «14», «:», «00», каждому присвоен числовой ID
Токенизация: как текст превращается в токены

Память модели 🧠

У каждой модели есть предел токенов в одной сессии — контекстное окно. Если его превысить, модель «забывает» начало диалога.

Стоимость 💳

В платных API оплачиваются и входящие токены (ваш запрос), и исходящие (ответ модели).

Учебный токенизатор: сколько «стоит» текст

Порядок как на занятии: выберите «Встреча», нажмите «Запомнить как A», затем добавьте поручение и сравните счёт. Считать слова вручную не нужно — важно увидеть, что исходник, поручение и история занимают место.

Настоящие токенизаторы: онлайн-сервисы и библиотеки

Сторонний инструмент показывает разбиение выбранного токенизатора. Он не гарантирует совпадения с любой моделью и не учитывает служебный объём конкретного чата.

Доступность сервисов — по данным урока; из сети вашей организации она может отличаться.

Промпт — это ТЗ, а не вопрос

Метафора: шеф-повар на аутсорсеСкажете повару «Сделай что-нибудь вкусное на обед» — он приготовит то, что считает вкусным сам. Например, устрицы, а у вас на них аллергия.

Дадите ТЗ — «Ты шеф-повар здорового питания. Приготовь сытный обед до 600 ккал без морепродуктов и сахара, подай в виде боула» — и результат совпадёт с ожиданиями с первого раза. Garbage In — Garbage Out: какой запрос, такой и ответ.

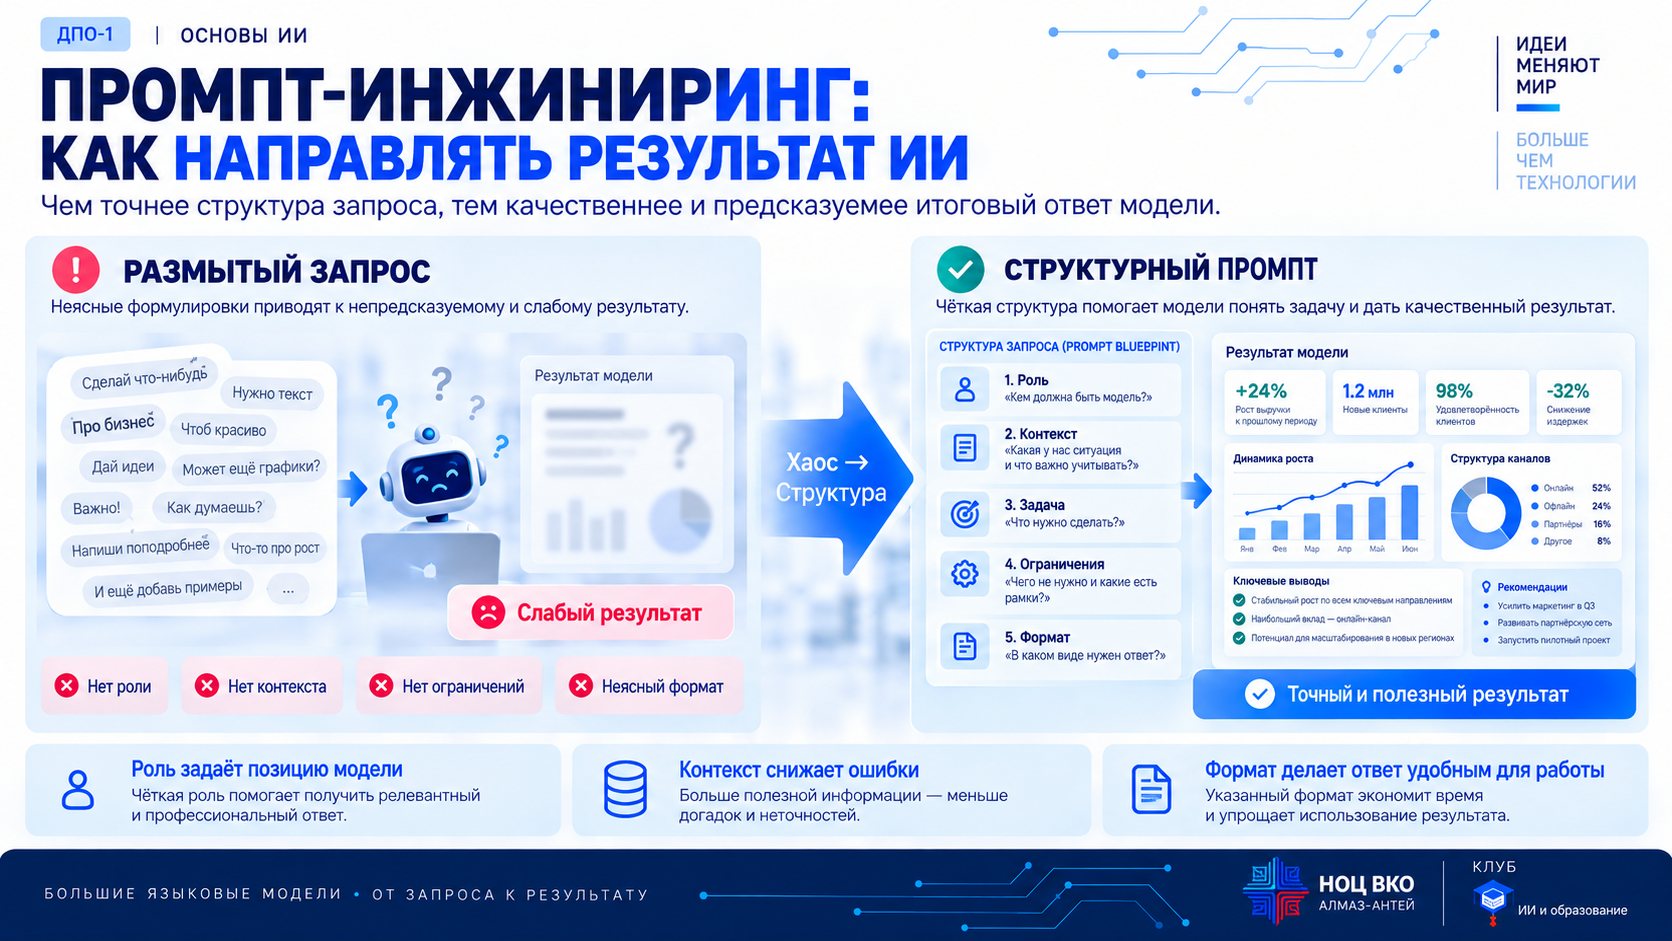
Промпт-инжиниринг: размытый запрос без роли, контекста, ограничений и формата даёт слабый результат, а структурный промпт — точный и полезный
Промпт-инжиниринг: как направлять результат ИИ

1. Роль 🎭

Кем ИИ должен себя вообразить: «Ты — главный технолог производственного предприятия».

2. Контекст 📂

Входные данные и ситуация: «Запускаем новую линию упаковки, бюджет ограничен».

3. Задача 🎯

Что конкретно сделать: «Составь перечень потенциальных рисков при запуске».

4. Ограничения 🚧

Чего делать нельзя: «Без вводных слов и абстракций, опирайся только на производственные факты».

5. Формат 📋

Как оформить: «Таблица из 3 колонок: Риск | Вероятность | Мера защиты».

Роль · Контекст · Задача · Ограничения · Формат — формула корпоративного MEGA-промпта из урока. Её же вы используете в домашнем задании.

❌ Размытый запрос (без контекста)

«Напиши письмо клиенту о задержке поставки оборудования».

Результат: сухой шаблонный текст, который звучит отстранённо и может разозлить клиента.

✅ Промпт-ТЗ

Роль, причина и срок задержки, получатель, компенсация и формат — всё в запросе (полный текст ниже).

Результат: готовое к отправке письмо, которое сохраняет лояльность клиента.

Промпт: письмо о задержке поставки (учебный пример)
Ты — опытный клиентский менеджер в B2G-сегменте.
Наша компания задерживает поставку станка на 3 дня из-за логистики.
Напиши вежливое, эмпатичное служебное письмо директору завода.
Объясни причину и предложи компенсацию — бесплатное сервисное обслуживание на месяц.
Формат: готовый черновик письма с темой.
Конструктор MEGA-промпта: соберите свой запрос

Виды промптов

Zero-shot — прямой

Запрос без примеров: «Объясни, что такое фотосинтез».

Few-shot — с примерами

Запрос с образцами нужного результата: «Вот пример тональности: […]. Напиши так же».

Chain-of-Thought — цепочка рассуждений

Просим рассуждать по шагам: «Рассуждай шаг за шагом, потом дай финальный ответ».

Что даёт хороший промпт. Сотрудник получает рабочий документ с первой попытки, а не тратит время на переделку и исправление выдумок. Команда пишет отчёты и служебные записки в едином стандарте. Меньше «воды» — меньше токенов и затрат в API.

Где граница. Даже идеальный промпт не гарантирует правильных фактов: он снижает риск ошибок, но не отменяет проверку. И никакой промпт не делает допустимой загрузку служебных данных во внешний сервис.

6

Контекстное окно: рабочий стол модели

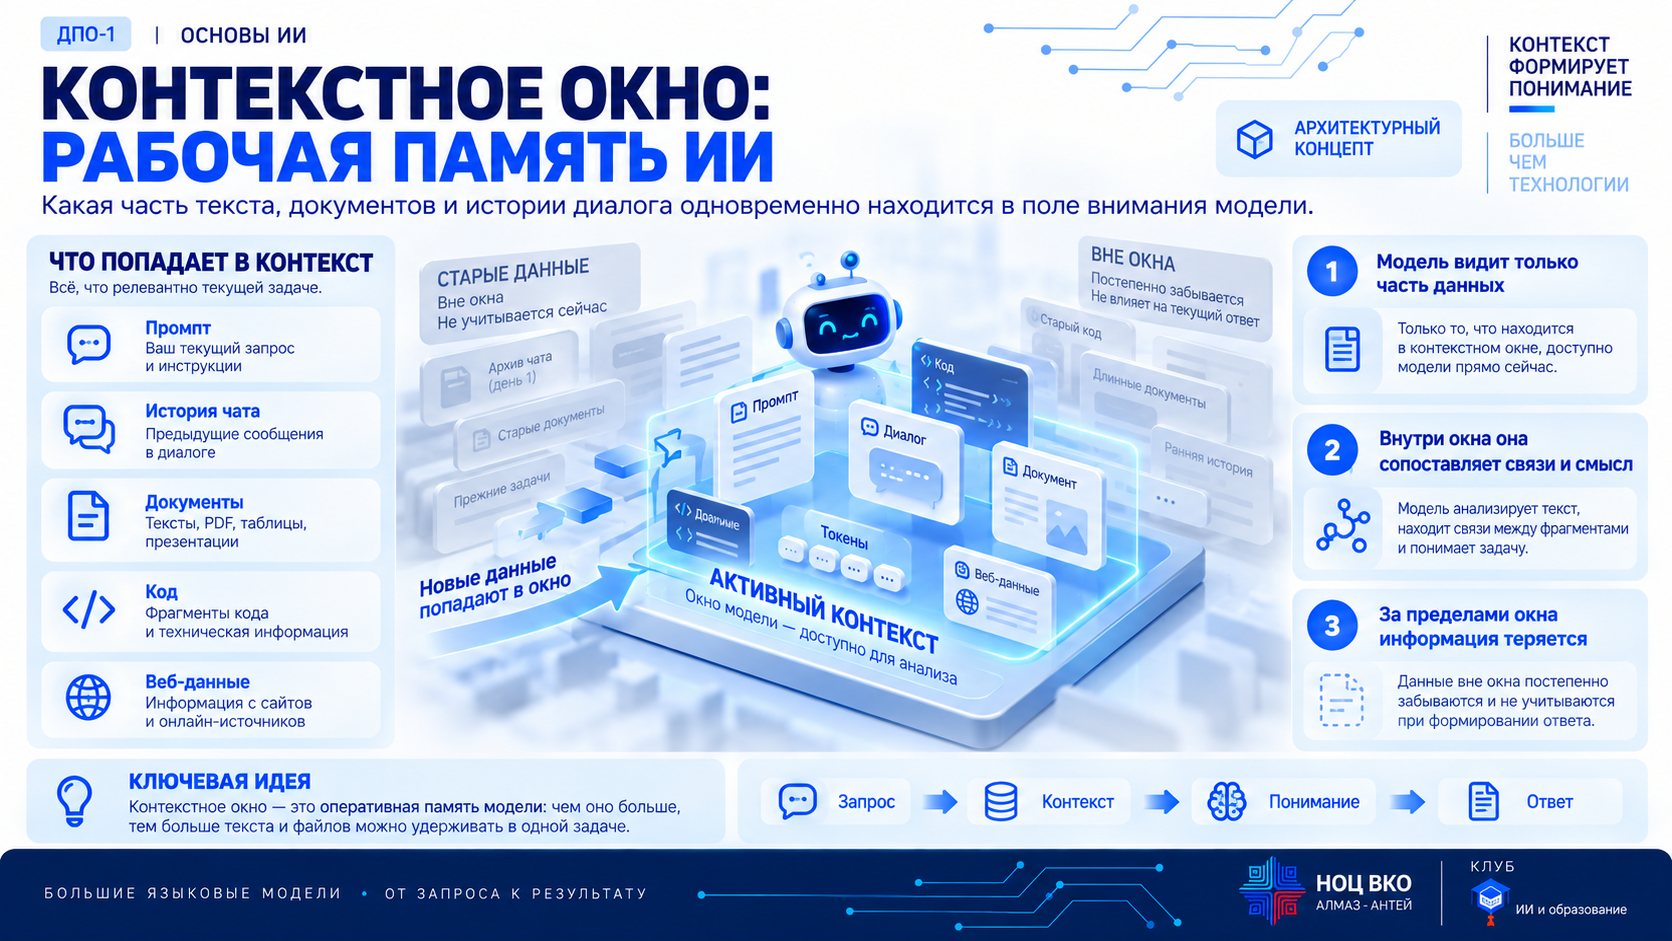
Контекстное окно — максимальный объём информации в токенах, который модель может учитывать при ответе в рамках одного диалога. Всё, что за его пределами, для модели как будто не существует.

ПРОМПТ

Поручение и данные для задачи.

ТОКЕН

Единица обработки текста — не обязательно слово.

КОНТЕКСТ

Сведения, доступные модели при ответе.

Метафора: рабочий стол мастераНа маленьком столе помещается один чертёж — чтобы взять второй, первый приходится убрать в шкаф. Большой стол (большое контекстное окно) позволяет разложить сотни страниц сразу.

Но если завалить стол горой документов, мастер начнёт путаться и терять листы в середине стопки. Это учебная аналогия, а не описание физической памяти.

Контекстное окно — рабочая память ИИ: в активный контекст попадают промпт, история чата, документы, код и веб-данные, а старые данные за пределами окна не учитываются
Контекстное окно: рабочая память ИИ
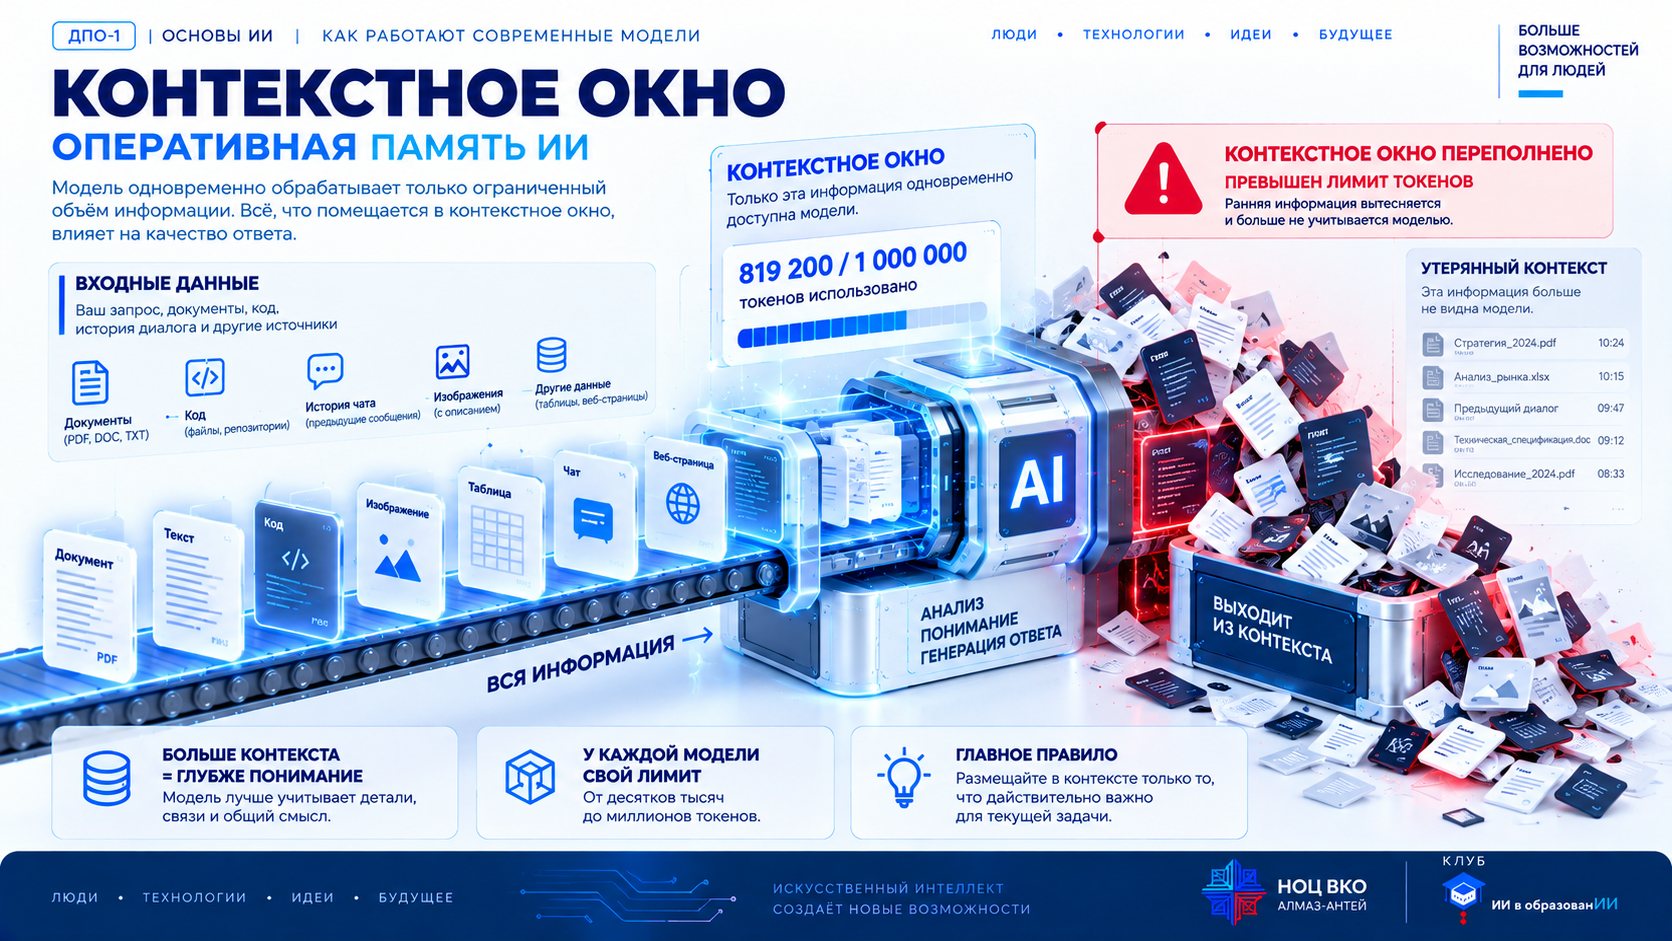
Переполненное контекстное окно: 819 200 из 1 000 000 токенов использовано, при превышении лимита старая информация вытесняется и выходит из контекста
Когда окно переполнено

Из чего складывается объём контекста

Окно заполняет не только последнее сообщение. Точный состав определяет сервис, но обычно это сумма четырёх частей:

1. Системный промпт ⚙️

Скрытые базовые инструкции и правила поведения от разработчиков или компании.

2. История диалога 💬

Все предыдущие вопросы и ответы в этой ветке — или та их часть, которую передаёт сервис.

3. Загруженные файлы 📎

Тексты, таблицы и документы, прикреплённые к чату (часто в обработанном виде).

4. Текущий запрос ✍️

Ваше новое сообщение.

Критический нюансПри каждом новом ответе модель заново обрабатывает весь переданный контекст. Чем длиннее чат, тем больше ресурсов уходит на каждый ответ и тем ближе модель к пределу своего «стола».

Три состояния окна: демонстрация

Схема 100 → 130 → 100 показывает условный бюджет, включая резерв на ответ. Нажмите «Следующее состояние»: A → B → C, затем «Сброс». «Старт» включает автоматическое переключение, «Пауза» его останавливает.

Три состояния контекстного окна

Наблюдение: A — бюджет 100; B — добавили материал, получилось 130; C — проверенное резюме истории возвращает сумму к 100.

Вывод: сокращение истории помогает вместить данные, но не гарантирует качество резюме. Проверяйте одновременно размер и смысл: старые и новые указания могут противоречить друг другу, а важное условие может потеряться при сокращении.

Условная схема автора урока, а не лимит конкретного сервиса. В реальности превышение может приводить к отказу, сокращению или обрезке истории — одинакового поведения у всех сервисов нет.

Эффект «Lost in the Middle» — потеря в середине

Внимание модели распределено неравномерно. Лучше всего она учитывает начало контекста (системные правила и роль) и конец (последний запрос). Факты, спрятанные в середине длинного документа или чата на 50–100 страниц, склонны «растворяться».

Представьте, что контекстное окно — рабочий чердак. Принесли 2–3 актуальные папки — мастер работает быстро и чётко. Свалили архив за 5 лет, инструкции к бытовой технике и всю переписку из мессенджеров — мастер путается, перечитывает ворох при каждом вопросе и теряет нужные документы посередине стопки.

Основание: исследование «Lost in the Middle» (Liu и соавторы, 2023) — о том, как модели используют длинный контекст. Это не универсальная гарантия поведения современных моделей: у новых версий эффект бывает слабее.

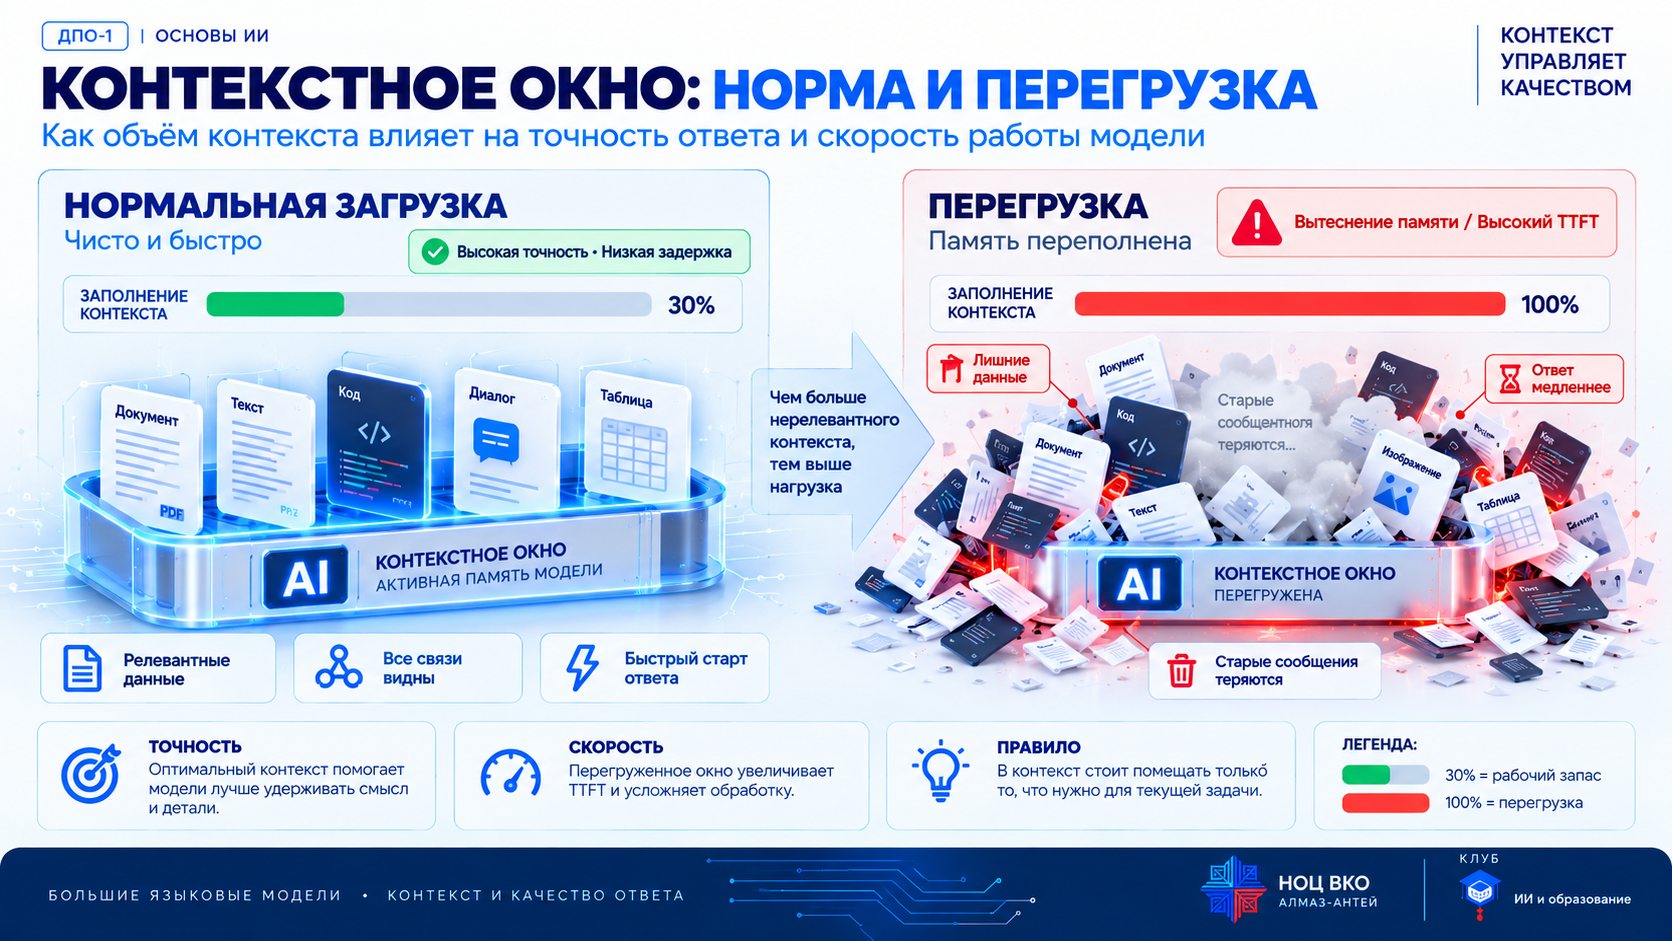
Контекстное окно: норма и перегрузка. При загрузке 30% модель работает быстро и точно, при 100% старые сообщения теряются, а ответ медленнее
Норма и перегрузка контекста

Три симптома перегруза контекста

🕳️ Потеря в середине

Модель видит начало и конец, а цифры и условия из середины огромного текста пропускает — и начинает додумывать.

⏳ Долгое ожидание ответа

Перед первым словом модель обрабатывает весь контекст. Чем он больше, тем дольше ждать начала ответа (TTFT — Time to First Token): вместо долей секунды — десятки секунд.

💸 Перерасход бюджета

В API платят за каждый входящий токен. Если снова и снова отправлять длинный чат, каждый новый короткий вопрос стоит в разы дороже.

Правила работы с контекстом

✂️ Один чат — одна задача

Не ведите все проекты года в одной ветке. Закончили отчёт — закройте диалог и начните новый: это очистит «рабочий стол».

📌 Главное — в конец

Загружаете большой документ или переписку — ставьте ключевую задачу и ограничения в самом конце промпта.

🧹 Промежуточная выжимка

В длинном проекте попросите: «Сделай краткую выжимку наших главных решений и условий». Проверьте её по смыслу и перенесите в новый чат как стартовый контекст.

Выгода для компании. Меньше «мусора» в контексте — меньше риска потерять исходное ТЗ и получить выдумку. В API очистка контекста заметно снижает расходы: вы не платите повторно за длинную историю в каждом запросе.

Сколько помещается в окно у разных моделей

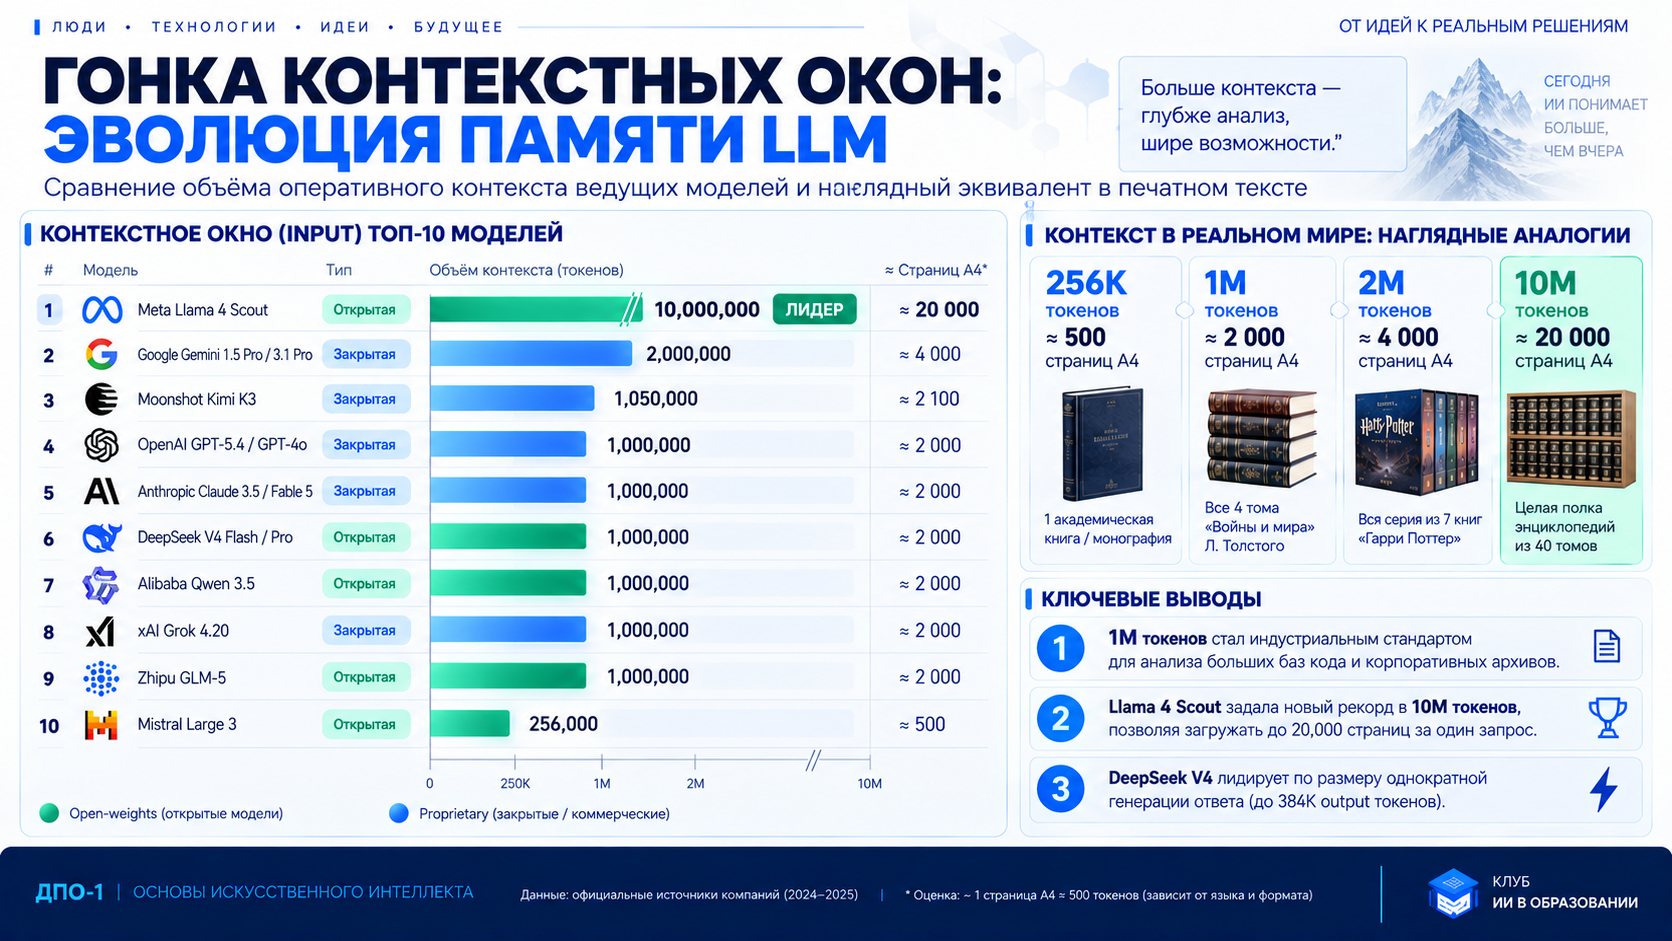
Топ контекстных окон LLM: лидер Llama 4 Scout — 10 миллионов токенов (около 20 000 страниц А4), у ряда моделей 1–2 миллиона токенов; наглядные аналогии от одной книги до полки энциклопедий
Эволюция памяти LLM: топ контекстных окон
🌟 Рекордсмен: Llama 4 Scout и 10 миллионов токенов

Открытую модель Llama 4 Scout компания Meta представила 5 апреля 2025 года. Заявленный объём контекста — 10 млн токенов: по грубой оценке, до 20 000 страниц текста за один запрос, как полка из 40 томов энциклопедии. Стандартом индустрии стали окна около 1 млн токенов.

Где применяют: анализ больших архивов документов без предварительной нарезки на фрагменты; работа с крупными репозиториями кода; размещение на собственных серверах компании (open-weights, архитектура Mixture-of-Experts: 109 млрд параметров, из них 17 млрд активных), чтобы данные не покидали периметр; мультимодальные задачи.

Оговорка: 10 млн — цифра разработчика. Уместиться в окно не значит одинаково хорошо учесть каждую страницу: эффект потери в середине и требования к серверам никуда не деваются.

Компания Meta признана экстремистской организацией и запрещена в России.

7

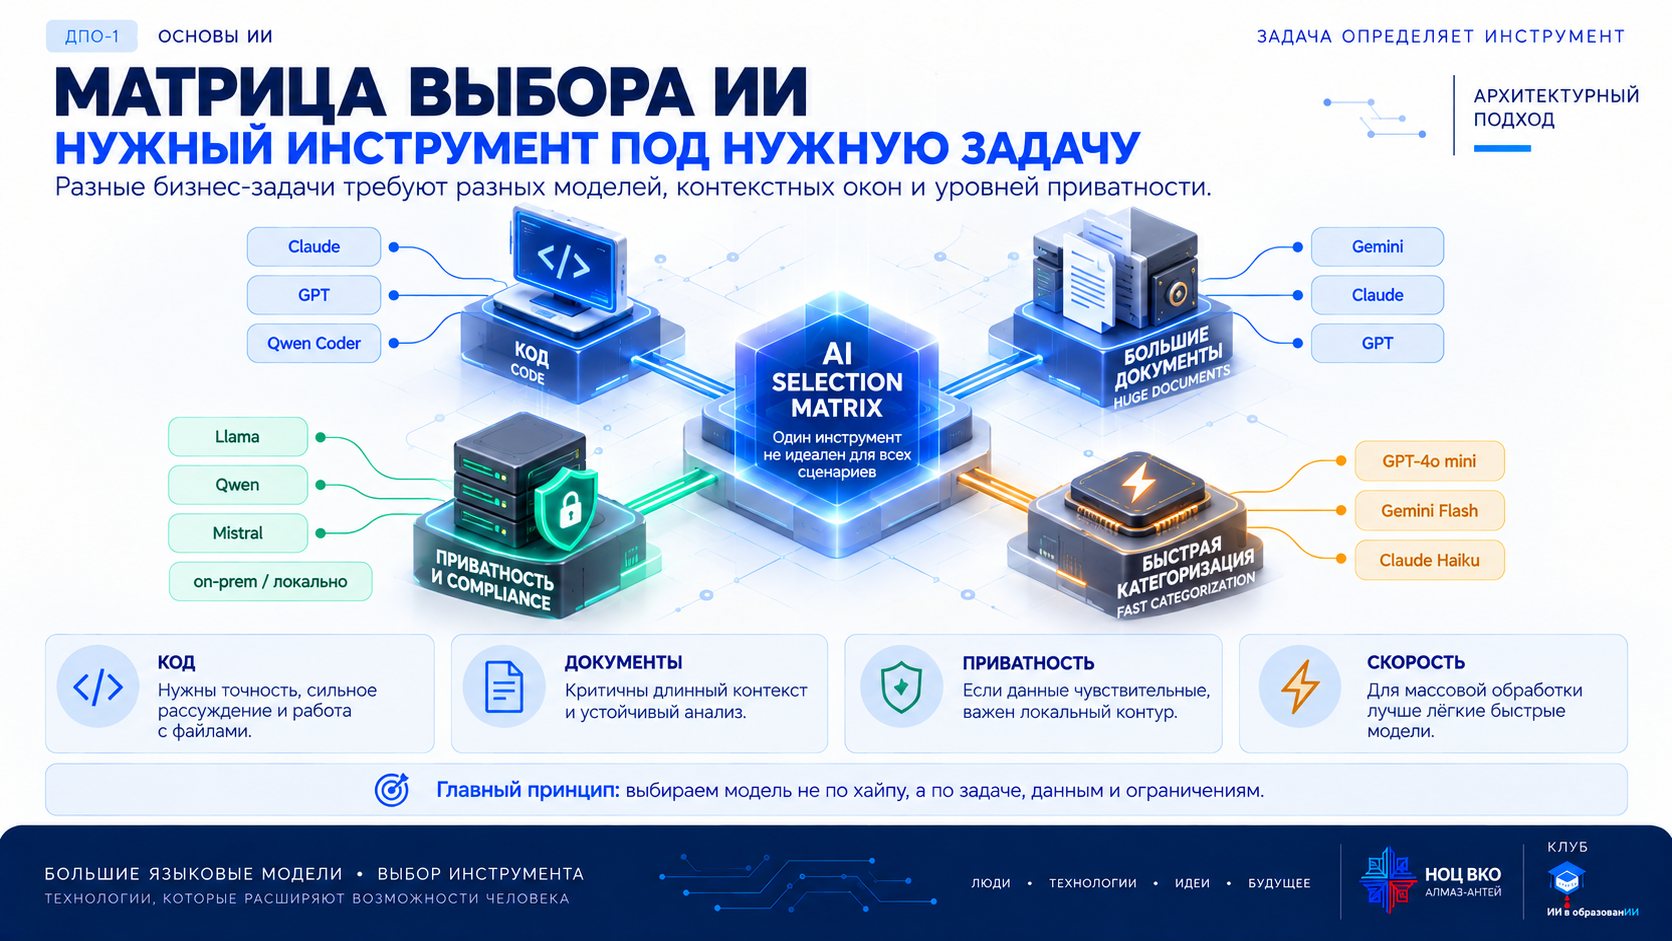
Выбираем инструмент по задаче, а не по рейтингу

ChatGPT · DeepSeek · GigaChat · Qwen · Gemini · YandexGPT. Идеальной нейросети «для всего» нет: лидерство в мировых рейтингах не гарантирует, что модель подходит под ваши задачи, юрисдикцию и требования к безопасности данных.

Метафора: автопарк компанииЕсли решать все задачи одной нейросетью — это всё равно что возить кирпичи на кабриолете. Представьте, что вы руководите логистикой и выбираете транспорт под груз.

🏎️ Спорткар

ChatGPT, Claude: быстрый и умный, но дорогой и не проедет по «бездорожью» закрытого корпоративного контура.

🚛 Карьерный самосвал

Gemini: за раз вывозит гору груза — книгу на 500 страниц или часовое видео, — где спорткар застрянет.

🚐 Бронированный инкассатор

GigaChat, YandexGPT: может проиграть заезд на международном треке, но именно ему проще доверить данные, которые по закону должны оставаться в России.

🚜 Тягач с открытым кодом

Qwen, DeepSeek: можно поставить в свой гараж — на сервер компании, — настроить под себя и не платить внешнему сервису за каждый километр.

Матрица выбора ИИ: для кода, больших документов, приватности и быстрой категоризации подходят разные модели — выбор по задаче, данным и ограничениям, а не по хайпу
Матрица выбора ИИ: нужный инструмент под нужную задачу

🚦 Три вопроса перед тем, как открыть чат с ИИ

Алгоритм выбора нейросети: ответьте на 3 вопроса

❌ Ошибочный подход

Сотрудник загружает PDF-отчёт на 400 страниц в чат с небольшим окном. Сервис выдаёт ошибку лимита или учитывает лишь часть файла — анализ получается поверхностным.

✅ Грамотный подход

Открытый отчёт анализируют в модели, чьё окно вмещает документ целиком (в уроке — Gemini), и модель видит связи между 1-й и 390-й страницей. Если такой модели нет — документ делят на части с проверенными выжимками.

❌ Ошибочный подход

Юрист отправляет черновик реального договора с персональными данными клиентов и реквизитами в зарубежный публичный чат-бот — «просто проверить орфографию».

✅ Грамотный подход

Юрист использует разрешённый в организации российский сервис или локальную нейросеть внутри контура компании. Данные не покидают правовое поле РФ, риск утечки заметно ниже.

Где границаВозможности сервисов, тарифы и доступ из РФ меняются. Как обработка большого файла зависит от тарифа и способа загрузки. Российский сервис — не автоматическое разрешение: для персональных данных и служебных материалов нужны согласие организации и подходящие условия обработки. Риск утечки снижается, но не становится нулевым.

🗺️ Справочник: шесть нейросетей — доступ из РФ и возможности

Дата проверки открытых официальных источников — 13 сентября 2026 года. Сравниваются в первую очередь пользовательские сервисы; функции API и бизнес-версий помечены отдельно. Наличие функции в семействе моделей не значит, что она включена в вашем чате.

СервисДоступ из РФ / VPNТекст, код, документыФото и изображенияАудио и видеоАгенты и автоматизация
ChatGPT
OpenAI
Не поддерживается РФ официально не поддерживается. VPN не гарантирует доступ и не отменяет ограничений. Список стран Тексты, переводы, код; анализ файлов и таблиц, выполнение кода для анализа данных; Canvas. Анализ фото и скриншотов; генерация и редактирование изображений. Голосовой диалог. Генерация видео — отдельный продукт, не стандартная функция любого чата. Deep research, специализированные GPT, подключённые приложения; действия зависят от режима и тарифа. Возможности
DeepSeek
сайт
Обычно без VPN Официальной гарантии доступа из любой сети РФ нет; доступ из вашей сети не проверен. Текст, код, рассуждения; поиск в интернете; загрузка файлов и извлечение текста. В API есть экспериментальная vision-модель; не приравнивать к обычному чату. Генерация картинок не подтверждена. Генерация аудио и видео, голосовой диалог в обычном чате не подтверждены. API и вызов инструментов для агентных интеграций — отдельная настройка. Чат · API
GigaChat
Сбер
VPN не нужен База знаний рекомендует выключить VPN перед входом. Вход по телефону или Сбер ID. Начало работы Создание и редактирование текстов, помощь с кодом, обработка документов. Генерация изображений в чате; анализ изображений — в документации моделей и API. Распознавание аудио — через API; озвучка — отдельный сервис SaluteSpeech. Видео в обычном чате не гарантировано. Вызов функций и интеграции через API. Модель · Файлы
Qwen
Alibaba
Обычно без VPN Официальной гарантии работы из любой сети РФ нет; вход и функции проверьте в своём аккаунте. Текст, программирование, документы, анализ данных и визуализации в Qwen Studio. Мультимодальный анализ; генерация и редактирование изображений в своём режиме. Понимание аудио и видео; голосовое общение в поддерживаемом интерфейсе. Генерация видео не во всех режимах. DeepResearch; Qwen Code — отдельный инструмент для программистов. Обзор
Gemini
Google
Региональное ограничение РФ нет в официальном списке регионов; VPN не гарантирует доступ. Регионы Тексты, код, анализ документов, таблиц и репозиториев; зависит от аккаунта. Анализ изображений; создание и редактирование в доступных режимах. Анализ загруженных аудио и видео; создание видео — с подпиской и региональным доступом. Gems — помощники с сохранёнными инструкциями, не обязательно автономные агенты. Gems
YandexGPT / Алиса AI
Яндекс
VPN не нужен Российский сервис. Полный доступ — через Яндекс ID; часть функций зависит от подписки. Тексты, пересказ, поиск, рассуждения, код, анализ документов. Алиса AI — сервис, YandexGPT — семейство моделей. Анализ, генерация и редактирование изображений. Голосовые сценарии; «Оживить» превращает фото в короткое видео в «Студии». Агент «Исследовать»; у бизнес-версии свои интеграции. Файлы · Исследовать

Отметки о VPN — справочная оценка по официальным источникам, а не тест подключения из РФ. Регион аккаунта, сеть, подписка и настройки организации могут ограничивать доступ. Таблица прокручивается по горизонтали.

Интерфейс и первые настройки

Краткие ориентиры по официальной справке. Расположение кнопок может меняться; авторизованный интерфейс каждого аккаунта не проверялся.

ChatGPT — интерфейс и настройки

Интерфейс: новый чат и история; поле сообщения, добавление файлов и выбор инструментов; голосовой режим. Projects объединяют чаты и файлы по задаче.

Настроить: язык и стиль ответа — в персонализации; проверить память; в Settings → Data Controls — использование данных и экспорт. Для разового разговора — Temporary Chat. Он не делает облачный сервис локальным или пригодным для секретных данных.

Интеграции: подключайте только нужные приложения и проверяйте их права. GPT с инструкциями и агент, который действует во внешних системах, — не одно и то же.

Начало работы и настройки данных

DeepSeek — интерфейс и настройки

Интерфейс: диалог, история, загрузка файлов; Search — поиск в интернете, DeepThink — режим подробного рассуждения.

Настроить: для актуальных сведений включайте поиск и проверяйте ссылки; для сложной задачи — режим рассуждения. Новая несвязанная задача — новый чат. Язык и формат ответа задавайте в запросе.

Важно: чат и API — разные способы доступа. API требует отдельного ключа; ключ нельзя вставлять в сообщения или общие документы.

Описание приложения · API

GigaChat — интерфейс и настройки

Интерфейс: «Новый чат», «Все чаты», «Избранное», профиль; поле ввода внизу. Меню «три точки» управляет отдельным диалогом.

Настроить: войдите по телефону или Сбер ID; при проблемах проверьте, что VPN выключен. Полезные диалоги добавьте в «Избранное». В запросе укажите объём, тон и формат; для картинки явно попросите «Нарисуй…».

Аудио и автоматизация: параметры API не ищите в настройках чата. Распознавание аудио — через поддерживаемую модель или API, синтез речи — SaluteSpeech.

Инструкция по интерфейсу · Генерация изображений · SaluteSpeech

Qwen — интерфейс и настройки

Интерфейс: Qwen Chat / Studio — чат с выбором режимов и загрузкой материалов; DeepResearch — для исследования вопроса. Веб- и мобильная версии могут различаться.

Настроить: сначала выберите режим под задачу: текст и код, исследование, изображение или мультимодальный ввод. Язык ответа укажите в запросе, перед загрузкой проверьте тип файла.

Программирование: Qwen Code устанавливается отдельно. Это агентный инструмент — не давайте ему неограниченных прав к файлам и внешним сервисам.

Обзор Qwen Studio · Qwen Code

Gemini — интерфейс и настройки

Интерфейс: новый диалог, история, поле запроса и добавление файлов; Gems — собственные инструкции; генерация видео — в боковой панели при наличии доступа.

Настроить: проверьте аккаунт и доступные режимы; в Settings / Activity — сохранение активности. Google Workspace подключайте только при необходимости. Для повторяющейся задачи создайте Gem с ролью, форматом и ограничениями.

Важно: Google-аккаунт и оплаченный тариф не снимают региональных ограничений.

Файлы и активность · Конфиденциальность

YandexGPT / Алиса AI — интерфейс и настройки

Интерфейс: чат, список диалогов, поле ввода; «+» — файлы и фото. «Студия» — визуальные задачи, вкладка «Оживить» делает из фото короткий ролик. «Исследовать» — исследовательский режим.

Настроить: войдите в нужный Яндекс ID, проверьте лимиты и подписку. Доступ к микрофону давайте только для голосовых функций. В настройках → «Управление ссылками» можно отозвать ссылки на диалоги.

Различие продуктов: функции Алисы AI, бизнес-версии и API моделей не равнозначны.

Оживление фото · Управление ссылками · Бизнес-функции

Перед первым использованием любого сервиса

  • Открывайте официальный адрес, а не посредника с похожим названием.
  • Проверьте на несекретном примере: вход, текстовый ответ, нужный тип файла и конкретную функцию.
  • «Без VPN» не значит «локально» или «в закрытом контуре»: все перечисленные веб-чаты — облачные сервисы.
  • Не загружайте пароли, персональные данные и закрытые рабочие материалы без разрешения и подходящих условий обработки.
  • Код проверяйте в тестовой среде; агентам давайте минимальные права, а важные внешние действия подтверждайте сами.
8

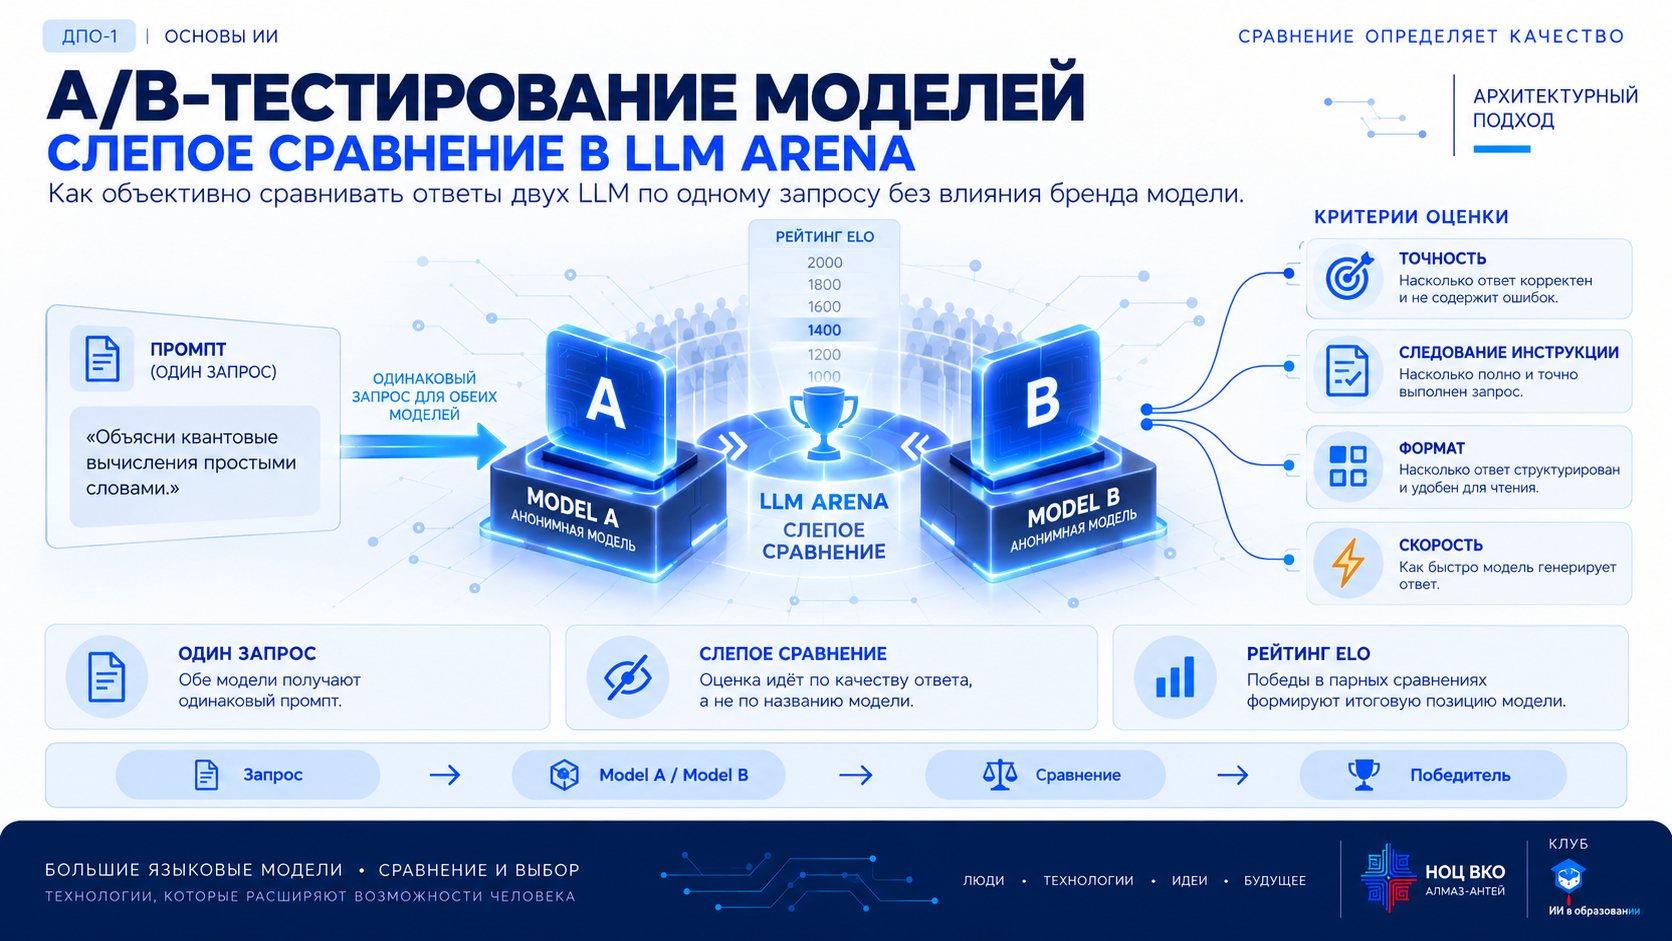
Один запрос в двух моделях: слепое сравнение в LLM Arena

LLM Arena — слепое A/B-тестирование: две нейросети отвечают на один и тот же промпт, названия скрыты, а оценка ставится только по качеству и точности ответа. Имена моделей открываются после голосования.

🏟️ Ресурс для практики: LLM Arena — arena.ai

Отправьте один обезличенный запрос двум анонимным моделям, сравните ответы и проголосуйте — названия моделей откроются после голоса. Доступ из РФ не проверялся; рабочие данные туда не отправляйте.

Открыть LLM Arena ↗

Метафора: слепая дегустацияВидите яркую этикетку известного бренда — срабатывает магия маркетинга. Нальёте кофе в два одинаковых безымянных стакана — оценка будет честной: выберете тот, что вкуснее, а не тот, у кого дороже реклама.

Если не «щёлкнуло»: это собеседование, где двум кандидатам дали одно тестовое задание и закрыли имена в резюме. Побеждает тот, чей черновик можно сразу нести директору.

A/B-тестирование моделей в LLM Arena: один промпт отправляется анонимным моделям A и B, пользователь сравнивает ответы по точности, следованию инструкции, формату и скорости, победы формируют рейтинг Elo
A/B-тестирование моделей: слепое сравнение в LLM Arena

📐 Пять критериев сравнения ответов

1. Точность и фактология

Есть ли выдуманные цифры, несуществующие законы или логические ошибки?

2. Следование ограничениям

Просили таблицу из 3 колонок без вводных слов — модель так и сделала? Игнорирование формата — главный грех слабых моделей.

3. Глубина и проработка

Поверхностная «вода» или экспертный разбор с конкретными шагами?

4. Структура и читаемость

Списки, логичные абзацы, выделения. Можно отправить руководителю без ручной правки?

5. Лаконичность

Нет ли пяти абзацев вежливых расшаркиваний перед сутью?

Слепое сравнение: оцените ответы А и Б

Зачем бизнесу внутренние A/B-тесты. Можно выяснить, что для первичной сортировки писем дорогая модель не нужна — справится модель в разы дешевле. Сотрудники перестают спорить, какая нейросеть «моднее», и выбирают по измеримому качеству.

Где граница. Публичный рейтинг арены отражает вкусы тысяч людей на их задачах, а не на ваших. Для рабочего выбора сравнивайте модели на своих типовых — но обезличенных — запросах.

Попробовать арену: Arena AI — открытый рейтинг языковых моделей на основе слепых сравнений. Доступ из РФ не проверялся; не отправляйте туда рабочие данные.

9

Итоги и домашнее задание

Задание собирает весь урок: сформулировать промпт по формуле из пяти элементов, получить и сравнить ответы, а затем проверить результат как эксперт.

🔒 Главный постулат безопасности: светофор данных

🛑 Категорически запрещено
Загружать в публичные и внешние нейросети реальные ТТХ изделий, закрытые чертежи, служебную переписку с грифом, персональные данные и коммерческую тайну.

🟢 Разрешено для ДЗ
Условные (синтетические) данные, обезличенные описания стандартного оборудования («насосная станция № 3», «условный блок питания БП-12»), учебные фрагменты ГОСТов и открытые регламенты.

🧱 Выберите одну из трёх рабочих задач

🔧 Инженерно-технологическая

Проект инструкции или методики проверки условного узла; анализ типового журнала сбоев оборудования.

📝 Документационная / управленческая

Сырые заметки с технического совещания → структурированный протокол с задачами и сроками.

📊 Аналитическая

Сравнение двух вариантов комплектующих или материалов по заданным критериям — в виде таблицы.

📥 Задание по шагам

Шаг 1. Соберите MEGA-промпт

  • Роль: «Ты — главный специалист по контролю качества на производстве электронных блоков».
  • Контекст: «Нужно подготовить краткий чек-лист проверки условного блока коммутации перед приёмкой».
  • Задача: «Сформируй пошаговый алгоритм осмотра из 5 пунктов».
  • Ограничения: «Деловой стиль, без общих фраз, понятные технические критерии, не придумывай несуществующие параметры».
  • Формат: «Таблица: № этапа | Что проверяем | Нормативное значение | Действие при отклонении».

Шаг 2. Запустите и сравните

  • Запустите промпт в выбранной нейросети — или сравните ответы двух доступных систем по пяти критериям из блока 8.
  • При необходимости уточните запрос: попросите убрать «воду» или сосредоточиться на рисках.
  • Длинная переписка — сделайте выжимку и продолжите в новом чате.

Шаг 3. Проверьте ответ как эксперт

Заполните карточку проверки:

  1. Есть ли в ответе выдумки или некорректные формулировки? Что именно исправлено?
  2. Соответствует ли формат исходному ТЗ?
  3. Какую выгоду по времени дал запрос? Например: вручную — 40 минут, ИИ — 30 секунд, правка — 3 минуты.
Шаблон промпта для ДЗ — подставьте свою задачу
Роль: Ты — [должность и экспертиза].
Контекст: [ситуация и обезличенные учебные данные].
Задача: [что конкретно сделать].
Ограничения: [чего делать нельзя; не придумывай параметры, которых нет в контексте].
Формат: [таблица / список / документ — с названиями колонок или разделов].

Что остаётся за человекомНейросеть готовит черновик. Решение, проверку фактов и нормативов, а также ответственность за документ несёт сотрудник. Ответ, который «звучит убедительно», — ещё не проверенный ответ.

📚 Полезные материалы

10

Чек-лист: работаю с нейросетью правильно

Пройдитесь по списку перед выполнением домашнего задания и перед любой рабочей задачей с ИИ. Отметки сохраняются в этом браузере.

Отмечено: 0

Перед первым запросом

Промпт по формуле MEGA

Контекст

Проверка ответа

11

Проверьте себя

Семь вопросов по материалу урока. После ответа правильный вариант подсвечивается, а ниже появляется разбор.

1. Что на самом деле делает большая языковая модель, когда отвечает на вопрос?

2. Какие три фактора, по уроку, стояли за прорывами в истории ИИ?

3. Почему один и тот же объём текста на русском обычно расходует больше токенов, чем на английском?

4. Что такое контекстное окно?

5. Вы загрузили в чат длинный отчёт, а важное условие спрятано в середине. Что делать по правилам урока?

6. Юристу нужно проверить черновик договора с персональными данными клиентов. Какой вариант соответствует уроку?

7. Зачем в LLM Arena скрывают названия моделей до голосования?

Отвечено: 0 / 7

Что забрать с собой

  1. Прорывы ИИ рождались на стыке трёх факторов — алгоритмов, мощности железа и данных. Сегодня технология впервые вышла за пределы лабораторий.
  2. LLM даёт не правду, а наиболее вероятное продолжение текста. Факты, цифры и ссылки в ответе проверяет человек.
  3. Промпт — это ТЗ: роль, контекст, задача, ограничения и формат. Токены — бюджет диалога, и русский текст расходует его быстрее.
  4. Контекстное окно — рабочий стол модели: один чат — одна задача, главное — в конец, длинную историю — в проверенную выжимку.
  5. Нейросеть выбирают по данным, объёму и задаче, а не по рейтингу. Служебные данные — только в разрешённые сервисы, качество — через слепое сравнение на своих обезличенных задачах.

Нейросеть — ваш быстрый, но фантазирующий стажёр. Ставьте ему чёткое ТЗ, не давайте секретов и проверяйте результат — тогда 40 минут ручной работы превращаются в 3 минуты правки.